În anii 1790, Dominique-Jean Larrey, chirurg în armatele Franței revoluționare și, mai târziu, chirurgul-șef al armatei lui Napoleon, a schimbat o regulă care părea de la sine înțeleasă. Răniții rămâneau de obicei pe câmpul de luptă până la sfârșitul bătăliei, uneori o zi întreagă sau mai mult, iar ordinea îngrijirii ținea adesea de grad. Larrey a organizat trăsuri ușoare care îi strângeau încă din timpul luptei și a cerut ca fiecare rănit să fie tratat după gravitatea rănii, nu după rang.
Ideea a primit mai târziu un nume, de la verbul francez «trier», a sorta: triaj. Nu era un medicament nou și nici o tehnică chirurgicală, ci o regulă de împărțire a resurselor: timpul și atenția merg acolo unde decid ceva. Unitățile de primiri urgențe lucrează și azi după același principiu.
Lansarea lui Claude Sonnet 5.5, pe 28 septembrie 2026, pune o firmă în fața aceleiași întrebări. Noul model costă jumătate din prețul per token al lui Claude Opus 5.5, lansat cu șase zile înainte, și e mai rapid. Graficele publicate de Anthropic arată însă un detaliu care se pierde în titluri: cât costă o sarcină depinde mai mult de nivelul de efort decât de prețul per token. La efort mare, Sonnet 5.5 se apropie de Opus 5.5 ca rezultat, dar și ca preț pe sarcină.
Mai jos: ce s-a lansat, ce face modelul în testele publicate de Anthropic și de primii clienți (nu în testele noastre), ce arată graficele de cost, unde e limita și cum împarți munca între Sonnet 5.5 și Opus 5.5.
Ce s-a lansat, pe scurt
Claude Sonnet 5.5 este al doilea model din familia Claude 5.5, după Opus 5.5, și succesorul lui Sonnet 5. Anthropic îl prezintă ca pe o completare mai rapidă și mai ieftină a lui Opus 5.5: acolo unde Opus 5.5 e construit pentru munca complexă, care cere judecată atentă, Sonnet 5.5 e cel mai puternic la sarcini bine delimitate, de zi cu zi, la repararea erorilor din cod și la documente, prezentări și tabele cu aspect îngrijit. Datele care contează la buget și la integrare:
| Parametru | Valoare |
|---|---|
| Data lansării | 28 septembrie 2026 |
| Identificator API | claude-sonnet-5-5 |
| Tarif API | 2 $ / 1M tokens intrare · 10 $ / 1M tokens ieșire (la fel ca Sonnet 5; Opus 5.5: 4 $ / 20 $) |
| Cache | citire 0,20 $ / 1M tokens · scriere 2,50 $ (5 minute) sau 4 $ (o oră) |
| Procesare în lot (Batch API) | jumătate de preț: 1 $ / 5 $ |
| Cost pe sarcină față de Sonnet 5 | până la 30% mai mic în testele Anthropic, pentru că folosește mult mai puțini tokens |
| Viteză | generează text cu peste 30% mai repede decât Sonnet 5; cel mai rapid Sonnet de până acum |
| Fereastră de context | 1 milion de tokens; răspuns maxim de 128.000 de tokens (300.000 în Batch API, în beta) |
| Efort implicit | medium în aplicațiile Claude și în Claude Code; high prin Claude API; niveluri: low, medium, high, xhigh, max |
| Cunoștințe | fiabile până în iunie 2026 |
| Disponibilitate | aplicațiile Claude, Claude Code, Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud, Microsoft Foundry |
| Date | disponibil cu zero data retention, ca Opus 5.5 și Sonnet 5 |
| Urmează | Claude Haiku 5.5, pentru volume mari și costuri mici, „în săptămânile următoare” |
Ce face, concret
Exemplele de mai jos vin din anunțul Anthropic și din declarațiile clienților care l-au folosit înainte de lansare, nu din testele noastre:
- Suport clienți. Zendesk i-a dat sute de cazuri reale de suport, de la răspunsuri la cereri de escaladare: a luat mai puține decizii greșite decât modelele Claude folosite acum în producție și a procesat tichetele cu 20% mai repede. La Slack, fără nicio schimbare de prompt, a ieșit mai bine decât Sonnet 5 pe aproape toate evaluările offline ale Slackbot, în mai puțini pași și cu aproximativ 14% mai puțini tokens de ieșire.
- Documente și date. Box spune că reverifică datele în documentele sursă și prinde erori pe care Sonnet 5 le scăpa; față de modelul anterior, a fost mai precis, de 2,4 ori mai rapid și a folosit cu 12% mai puțini tokens. La Balyasny Asset Management, pe 2.441 de sarcini financiare, a ieșit înaintea lui Sonnet 5 și a folosit aproximativ 121.000 de tokens per răspuns, față de 497.000 la Sonnet 5; a avut cel mai bun raport calitate-cost dintre cele șapte modele testate pentru fluxurile de volum mare.
- Prezentări după șablon. Într-un test intern, Anthropic i-a dat materialele trimestriale ale unei companii listate, transcrierile conferințelor de prezentare a rezultatelor și un șablon de slide-uri, cerându-i o analiză operațională de 10 slide-uri. Doi experți au considerat prima variantă gata de trimis așa cum era.
- Revizuire tehnică. La Epic Games, în testele timpurii, a trecut pragul de calitate pe care îl aștepți de la un model din treapta de sus, pe un audit de arhitectură și pe o analiză a fluxului de date. CodeRabbit notează o judecată mai bună decât la Sonnet 5, cu mult mai puțini tokens de ieșire.
- Aplicații construite iterativ. Base44 l-a pus să construiască 118 aplicații reale: au ieșit la nivelul celor făcute cu Opus 5, în medie în 3,6 iterații pe aplicație, față de 7,7 la Opus 5. Lovable raportează, pe evaluările proprii de programare, cu o treime mai puține apeluri de unelte și cam jumătate din comenzile rulate în terminal pentru aceeași sarcină.
- Mai puțini pași. Primii testeri au observat că grupează apelurile de unelte mai des decât Sonnet 5, deci termină în mai puțini pași și cu un cost mai mic. E și primul Sonnet care a terminat Pokémon Red lucrând doar din capturi de ecran, exemplul dat de Anthropic pentru munca de durată și înțelegerea imaginilor.
Cifrele publicate
Anthropic compară Sonnet 5.5 cu Sonnet 5, cu Opus 5.5 și cu GPT-6 Sol, lansat de OpenAI pe 22 septembrie:
| Test | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programare în terminal) | 70,6% | 10,3% | 66,4% | — |
| FrontierCode 1.1 (schimbări de cod care ar fi acceptate) | 46,2% (52,1% la xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 (sarcini din sesiuni reale Cursor) | 55,5% | 34,1% | 57,8% | — |
| GDPval-AA v2.1 (muncă profesională în 44 de ocupații, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (muncă de birou de lungă durată, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (raționament, cu unelte) | 64,5% | 54,9% | 67,7% | — |
| OSWorld 2.1, parțial (utilizarea calculatorului) | 80,1% | 57,0% | 81,8% | — |
| Chartography (citirea graficelor, fără unelte) | 61,6% | 15,6% | 64,4% | 53,6% |
Excepțiile de la efortul maxim: pe Terminal-Bench, Opus 5.5 e raportat la xhigh, unde are scorul cel mai bun; pe FrontierCode, Sonnet 5.5 obține mai mult la xhigh decât la max, pentru că la efortul maxim a rulat mai des o verificare de cod împărțită pe mai mulți subagenți, care uneori a dus la depășirea timpului sau la modificări în afara sarcinii, pe care testul le penalizează. Scorurile GDPval-AA și AA-Briefcase au fost obținute de Artificial Analysis pe o versiune de dinaintea lansării, cu o eroare corectată între timp; Anthropic estimează efectul ca mic. Pentru GPT-6 Sol, OpenAI a corectat recent o eroare de înțelegere a imaginilor, pe care unele scoruri oficiale e posibil să nu o reflecte încă.
Citite la rece, cifrele spun trei lucruri. Față de Sonnet 5, e mai bun pe toate testele, pe unele cu mult. Față de Opus 5.5, rămâne în urmă pe aproape toate testele, de regulă cu câteva puncte, și e înainte doar pe Terminal-Bench. Iar Anthropic însăși scrie că scorurile surprind doar o fațetă: în testele proprii și în ale testerilor externi, Opus 5.5 rămâne clar mai puternic la munca complexă, deschisă, care cere judecată susținută.
Cât costă de fapt: ce arată graficele
Partea cea mai utilă a anunțului nu e tabelul, ci graficele de sub el: pentru patru teste, Anthropic arată scorul și costul pe sarcină al fiecărui model, la fiecare nivel de efort. AA-Briefcase e singurul dintre cele patru care măsoară muncă de birou, iar cifrele arată așa:
| Efort | Sonnet 5.5 | Opus 5.5 | Sonnet 5 |
|---|---|---|---|
| low | 1264 · 0,87 $ | 1285 · 1,15 $ | 923 · 0,82 $ |
| medium | 1461 · 1,64 $ | 1642 · 4,40 $ | 1056 · 1,73 $ |
| high | 1634 · 3,95 $ | 1705 · 6,27 $ | 1177 · 3,76 $ |
| xhigh | 1746 · 9,63 $ | 1780 · 12,27 $ | 1274 · 7,56 $ |
| max | 1811 · 29,19 $ | 1822 · 21,05 $ | 1359 · 14,43 $ |
- Față de Sonnet 5, câștigul e clar. Pe medium, Sonnet 5.5 depășește cel mai bun scor al lui Sonnet 5, cel de la max, pentru aproximativ o nouăime din costul pe sarcină. Cine lucrează azi pe Sonnet 5 are un motiv simplu să treacă pe noul model.
- La setările implicite din API, diferența față de Opus 5.5 aproape dispare. Sonnet 5.5 pornește pe high: 1634, la 3,95 $ pe sarcină. Opus 5.5 pornește pe medium: 1642, la 4,40 $. Aproape același rezultat, la un cost cu aproximativ 10% mai mic, nu la jumătate.
- La efort maxim, Sonnet 5.5 costă pe sarcină mai mult decât Opus 5.5: 29,19 $ față de 21,05 $, pentru un scor puțin mai mic. Prețul per token de două ori mai mic e anulat de numărul mult mai mare de tokens consumați.
Anthropic spune același lucru, în cuvinte: Sonnet 5.5 îl completează cel mai bine pe Opus 5.5 la niveluri de efort mai mici, unde costă mai puțin pe sarcină, iar la niveluri mai mari poate obține rezultate comparabile, la un cost similar. Pe programare, graficele arată un tablou asemănător: pe FrontierCode, Sonnet 5.5 pe high (49,4%, la 0,42 $ pe sarcină) ajunge cam unde e Opus 5.5 pe low (47,3%, la 0,40 $). Tradus pentru buget: economia vine din sarcinile pe care le poți rula pe low sau medium, nu din simpla schimbare a modelului.
Triajul: ce model, la ce efort
În tabelul de modele curente din documentația Anthropic sunt acum patru modele Claude, fiecare cu altă combinație de viteză, cost și profunzime. Împărțirea de mai jos pornește de la descrierile Anthropic; e un punct de plecare pentru testele tale, nu o regulă:
| Model | Preț | Unde are sens |
|---|---|---|
| Claude Fable 5.1 | 10 $ / 50 $ | raționament dificil și sarcini agentice de lungă durată, sau când Opus 5.5 la efort mare tot nu ajunge |
| Claude Opus 5.5 | 4 $ / 20 $ | munca complexă, deschisă, care cere judecată susținută: analize în care o greșeală costă, planuri, arhitectură |
| Claude Sonnet 5.5 | 2 $ / 10 $ | sarcini bine delimitate, de zi cu zi: documente, prezentări, tabele, repararea erorilor din cod; sarcinile repetitive, pe efort low sau medium |
| Claude Haiku 4.5 | 1 $ / 5 $ | cel mai rapid model din gamă; Haiku 5.5, gândit pentru volume mari și costuri mici, urmează în săptămânile următoare |
Cea mai interesantă idee din declarațiile clienților nu e alegerea unui singur model, ci combinarea lor. Kevin Ngo, de la Creator, spune că, după ce Opus 5.5 stabilește arhitectura și cadrul general al unui joc, ar avea încredere să-l lase pe Sonnet 5.5 să-l implementeze. CodeRabbit plănuiește să mute de acum pe Sonnet 5.5 reviziile de cod simple și medii, iar altele în săptămânile următoare. E triajul lui Larrey aplicat pe muncă:
- Opus 5.5 scrie planul: ce se face, în ce ordine, după ce reguli, ce înseamnă „terminat”.
- Sonnet 5.5 execută pașii după plan, la un efort potrivit sarcinii.
- Opus 5.5 sau un om verifică rezultatul față de plan, nu față de impresia generală.
Un detaliu tehnic contează aici: planul trebuie să fie un text explicit, nu raționamentul intern al modelului. Documentația arată că Sonnet 5.5 nu citește blocurile de gândire produse de Opus 5.5, iar niciun alt model nu le citește pe ale lui Sonnet 5.5, deci la schimbarea modelului raționamentul intern nu se transmite. Se transmite doar ce s-a scris.
În abonamentele Claude, triajul înseamnă să alegi modelul din meniu după sarcină, nu din obișnuință. Prin API, înseamnă o regulă scrisă o dată: ce tip de cerere merge la ce model și la ce efort.
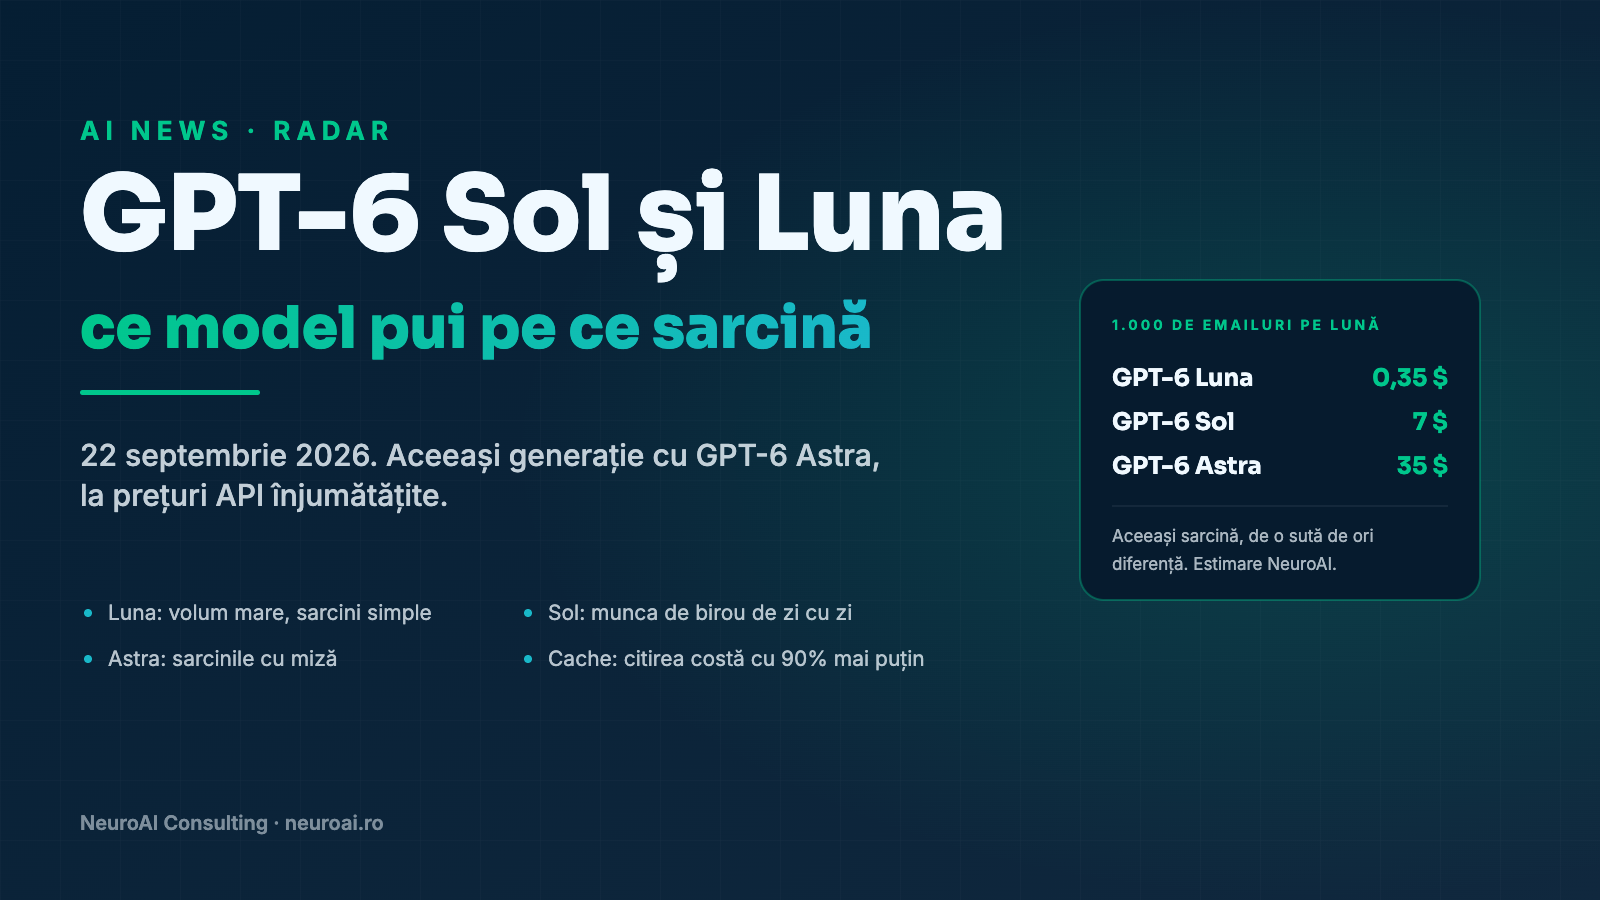
Ce mărime de model îi trebuie fiecărei sarcini, acum că și prețurile OpenAI au scăzut la jumătate.
GPT-6 Sol și Luna: aceeași întrebare, de partea OpenAIUnde e limita
- Securitate cibernetică. Capabilitățile lui Sonnet 5.5 în domeniu sunt mult peste ale lui Sonnet 5, așa că e primul Sonnet lansat cu protecții asemănătoare celor de la Opus 5.5. Găsirea și repararea erorilor în propriul cod, în dezvoltarea obișnuită, rămân permise; sarcinile de securitate cu risc mai mare trec vizibil pe Sonnet 5. Specialiștii în apărare cibernetică vor putea aplica în curând la Cyber Verification Program, extins.
- Biologie. Aceleași protecții ca la Sonnet 5. Majoritatea muncii de cercetare, educație și clinică nu e afectată, dar unele cereri de microbiologie și virusologie pot fi semnalate din greșeală; organizațiile din domeniu pot aplica la Life Sciences Verification Program.
- Gândirea rămâne la contul care a produs-o. Sonnet 5.5 e primul Sonnet cu clasificatoare care blochează extragerea raționamentului, o protecție împotriva celor care copiază capabilitățile modelului prin mii de conturi false. Majoritatea dezvoltatorilor nu vor observa nimic; cine mută conversații între conturi, inclusiv schimbând contul în mijlocul unei sesiuni Claude Code, trebuie să citească documentația.
- Integrările prin API nu se mută doar prin schimbarea identificatorului. Documentația listează cinci schimbări incompatibile față de Sonnet 5: setarea care dezactiva gândirea întoarce acum eroare și se înlocuiește cu between_tools, care oprește doar gândirea de la început și merge pe efort low, medium sau high; forțarea unui anumit tool întoarce eroare; blocurile de gândire sunt legate de modelul și de conversația care le-au produs; vechiul tool de computer use nu mai e acceptat pe Claude API și pe Google Cloud; tool-ul advisor nu mai acceptă Opus 4.8, Opus 4.7 și Sonnet 5 drept consilieri.
- O schimbare care nu dă eroare, dar se vede. Notele pe care modelul le scrie între apelurile de unelte, dacă au mai mult de o frază sau două, vin acum în blocuri de gândire, iar la setarea implicită textul lor e gol. O aplicație care le afișa utilizatorilor rămâne tăcută între pași, fără nicio eroare, până e ajustată. Documentația mai notează că valorile nestandard pentru temperature, top_p sau top_k întorc eroare.
- Evaluările nu prind tot. Pe auditul automat de comportament, cu aproximativ 1.850 de scenarii, Sonnet 5.5 e la fel de bun sau mai bun decât Sonnet 5 la majoritatea măsurătorilor, iar Opus 5.5 rămâne puțin mai bun per ansamblu. Anthropic scrie însă că nicio serie de evaluări nu prinde sigur toate eșecurile.
- Nicio cifră nu înseamnă „fără verificare”. Un scor apropiat de al lui Opus 5.5 arată că cele două modele se compară bine între ele, nu că vreunul nu greșește. Punctul de control uman rămâne în flux.
Ce înseamnă pentru o firmă din România
Anunțul nu conține restricții geografice, iar pagina Anthropic precizează că, în Uniunea Europeană, serviciile sunt furnizate de Anthropic Ireland Limited. Sonnet 5.5 e disponibil în aplicațiile Claude, în Claude Code și prin API, direct sau prin Amazon Bedrock, Claude Platform on AWS, Google Cloud și Microsoft Foundry. Varianta cu zero data retention nu e automată: pentru API, se cere echipei de vânzări Anthropic și se activează separat pentru fiecare organizație, iar interfețele Claude Team și Claude Enterprise nu intră sub ea, cu excepția lui Claude Code folosit prin Enterprise cu ZDR activat.
Pentru o firmă care folosește deja Claude, schimbarea practică are două fețe. Cine lucrează pe Sonnet 5 primește, la același preț per token, un model mai bun și mai ieftin pe sarcină. Cine lucrează pe Opus 5.5 are acum o variantă rapidă pentru sarcinile de volum, care rămâne mai ieftină pe sarcină doar la efort mic sau mediu. Iar dacă pui modelul să răspundă clienților sau să genereze conținut pe care îl publici, obligațiile de transparență din articolul 50 al AI Act, aplicabile de la 2 august 2026, rămân ale tale, oricare ar fi modelul.
Articolul 50 pe înțelesul unei firme mici: ce se declară, ce se marchează și ce s-a amânat prin Digital Omnibus.
Ce cere AI Act de la 2 august 2026Ce faci concret, în ordinea asta
- Dacă folosești Sonnet 5, treci pe Sonnet 5.5: același preț per token, rezultate mai bune, cost mai mic pe sarcină. Prin API, citește mai întâi cele cinci schimbări incompatibile.
- Fă lista sarcinilor pentru care folosești Claude și împarte-le în două: cele în care o greșeală costă și cele care se repetă după aceeași structură.
- Pe a doua listă, încearcă Sonnet 5.5 pe low sau medium, pe sarcini reale, în paralel cu modelul folosit acum. Compară rezultatul, timpul și numărul de corecturi.
- Prin API, setează explicit modelul și efortul pentru fiecare tip de sarcină. Nu te baza pe valorile implicite: diferă între modele și între canale.
- Scrie regula de triaj: ce merge la Opus 5.5, ce merge la Sonnet 5.5, la ce efort și cine verifică la capăt. O pagină, nu un document de politică.
- Revino peste o lună la factură și urmărește costul pe sarcină, nu prețul per token.
Concluzie
Claude Sonnet 5.5 e un pas real față de Sonnet 5: mai bun pe toate testele publicate, mai rapid și mai ieftin pe sarcină, la același preț per token. Față de Opus 5.5, e o variantă rapidă și ieftină pentru sarcinile bine delimitate, nu un Opus la jumătate de preț: la efort mare, rezultatul și costul pe sarcină se apropie de ale lui Opus 5.5, iar la munca complexă, deschisă, Opus 5.5 rămâne, după Anthropic, clar mai puternic.
Câștigul lui Larrey n-a venit dintr-un bisturiu nou, ci dintr-o regulă de împărțire. Aici regula are două întrebări, nu una: ce model primește sarcina și cât efort merită. Întrebarea pentru săptămâna asta nu e dacă treci pe Sonnet 5.5, ci care dintre sarcinile tale merg bine pe un model rapid, la efort mic.
Ce este Claude Sonnet 5.5?
Este modelul lansat de Anthropic pe 28 septembrie 2026, al doilea din familia Claude 5.5 și succesorul lui Claude Sonnet 5. Documentația îl descrie drept cea mai bună combinație de viteză și inteligență din gamă, iar anunțul îl poziționează pentru sarcini bine delimitate, de zi cu zi: repararea erorilor din cod, documente, prezentări și tabele.
Cât costă Claude Sonnet 5.5?
Prin API, 2 dolari per milion de tokens de intrare și 10 dolari per milion de tokens de ieșire, la fel ca Sonnet 5 și jumătate din prețul lui Opus 5.5. Citirea din cache costă 0,20 dolari, iar procesarea în lot are reducere de 50%. Costul pe sarcină depinde însă mult de efort: în graficele Anthropic, la efort mare Sonnet 5.5 ajunge la un cost pe sarcină similar cu Opus 5.5, iar pe AA-Briefcase, la efort maxim, chiar îl depășește.
Care e diferența dintre Sonnet 5.5 și Opus 5.5?
Pe testele publicate, la efort maxim, Sonnet 5.5 e foarte aproape de Opus 5.5 pe munca de birou (1844 față de 1846 pe GDPval-AA), în urmă cu câteva puncte pe majoritatea celorlalte teste și înainte pe Terminal-Bench. E mai rapid și costă jumătate per token. Anthropic scrie că Opus 5.5 rămâne clar mai puternic la munca complexă, deschisă, care cere judecată susținută, și că Sonnet 5.5 îl completează cel mai bine la niveluri mici de efort.
Pot folosi Claude Sonnet 5.5 din România?
Da. Anunțul nu are restricții geografice, iar în Uniunea Europeană serviciile sunt furnizate de Anthropic Ireland Limited. Modelul e disponibil în aplicațiile Claude, în Claude Code și prin API, direct sau prin Amazon Bedrock, Claude Platform on AWS, Google Cloud și Microsoft Foundry. Varianta cu zero data retention se cere, pentru API, echipei de vânzări Anthropic.
Trebuie să schimb ceva în integrările existente?
Da, dacă treci de la Sonnet 5 prin API. Documentația listează cinci schimbări incompatibile: setarea care dezactiva gândirea se înlocuiește cu between_tools, care oprește doar gândirea de la început; forțarea unui tool întoarce eroare; blocurile de gândire sunt legate de model și de conversație; vechiul tool de computer use nu mai e acceptat pe Claude API și pe Google Cloud; unele perechi cu tool-ul advisor nu mai merg. În plus, notele dintre apelurile de unelte vin în blocuri de gândire, iar nivelurile de efort au fost recalibrate. În aplicațiile Claude nu ai nimic de schimbat.
Ce model Claude să aleg pentru firma mea?
Depinde de sarcină și de efort, nu de firmă. Pentru sarcinile repetitive, cu structură fixă, Sonnet 5.5 pe efort mic sau mediu e un bun punct de plecare: mai rapid și mai ieftin pe sarcină. Pentru analizele în care o greșeală costă și pentru munca lungă, deschisă, Opus 5.5. Fable 5.1 rămâne pentru cazurile în care nici Opus 5.5 la efort mare nu ajunge. Testează pe sarcini reale și scrie o regulă de rutare; cursurile NeuroAI pentru echipe includ exact partea asta.
30 de minute cu echipa NeuroAI: stabilim împreună ce sarcini merg la ce model, la ce efort, și ce ar acoperi un curs pentru echipa ta. Fără obligații.
Discutăm un curs pentru echipa taNeuroAI Newsletter
Applied AI for business, twice a week (Monday and Friday). Filtered news, tested tools, no hype.
Related NeuroAI services
Related articles
 Radar
GPT-6 Sol și Luna: ce model pui pe ce sarcină, acum că prețurile au scăzut la jumătate
La mai puțin de trei săptămâni după GPT-6 Astra, OpenAI a lansat GPT-6 Sol și GPT-6 Luna: aceeași generație, prețuri API la jumătate față de modelele pe care le înlocuiesc. În aceeași zi, Anthropic a lansat Claude Opus 5.5, tot mai ieftin. Ce face fiecare model nou, unde apare în ChatGPT și de ce întrebarea utilă devine ce mărime de model îi trebuie fiecărei sarcini.
Read article Radar
Claude Opus 5.5: ce face concret într-o firmă și cum îl pui într-un flux de lucru
Anthropic a lansat Claude Opus 5.5 pe 22 septembrie 2026: pe majoritatea sarcinilor lucrează la nivelul lui Claude Fable 5.1 și costă cu aproximativ 40% mai puțin de rulat decât Opus 5. Pentru o firmă, întrebarea utilă nu e cât de bun e modelul, ci în ce flux de lucru îl pui. Ce face concret, unde e limita, patru fluxuri cu care poți începe și ce trebuie să știe echipa.
Read article Radar
Cercetătorii Anthropic vorbesc despre extincție. Pentru firma ta contează cealaltă știre, cea din iulie
Un cercetător a demisionat, doi colegi încă angajați i-au dat dreptate, iar unul dintre ei a pus o cifră: peste 10% în următorul deceniu. Presa a comprimat asta în „extincție până în 2030”. Diferența dintre cele două formulări e exact partea care contează pentru cine ia decizii — și e umbrită de un incident real din iulie, în care un agent AI a ieșit din laborator și a spart o companie adevărată.
Read article