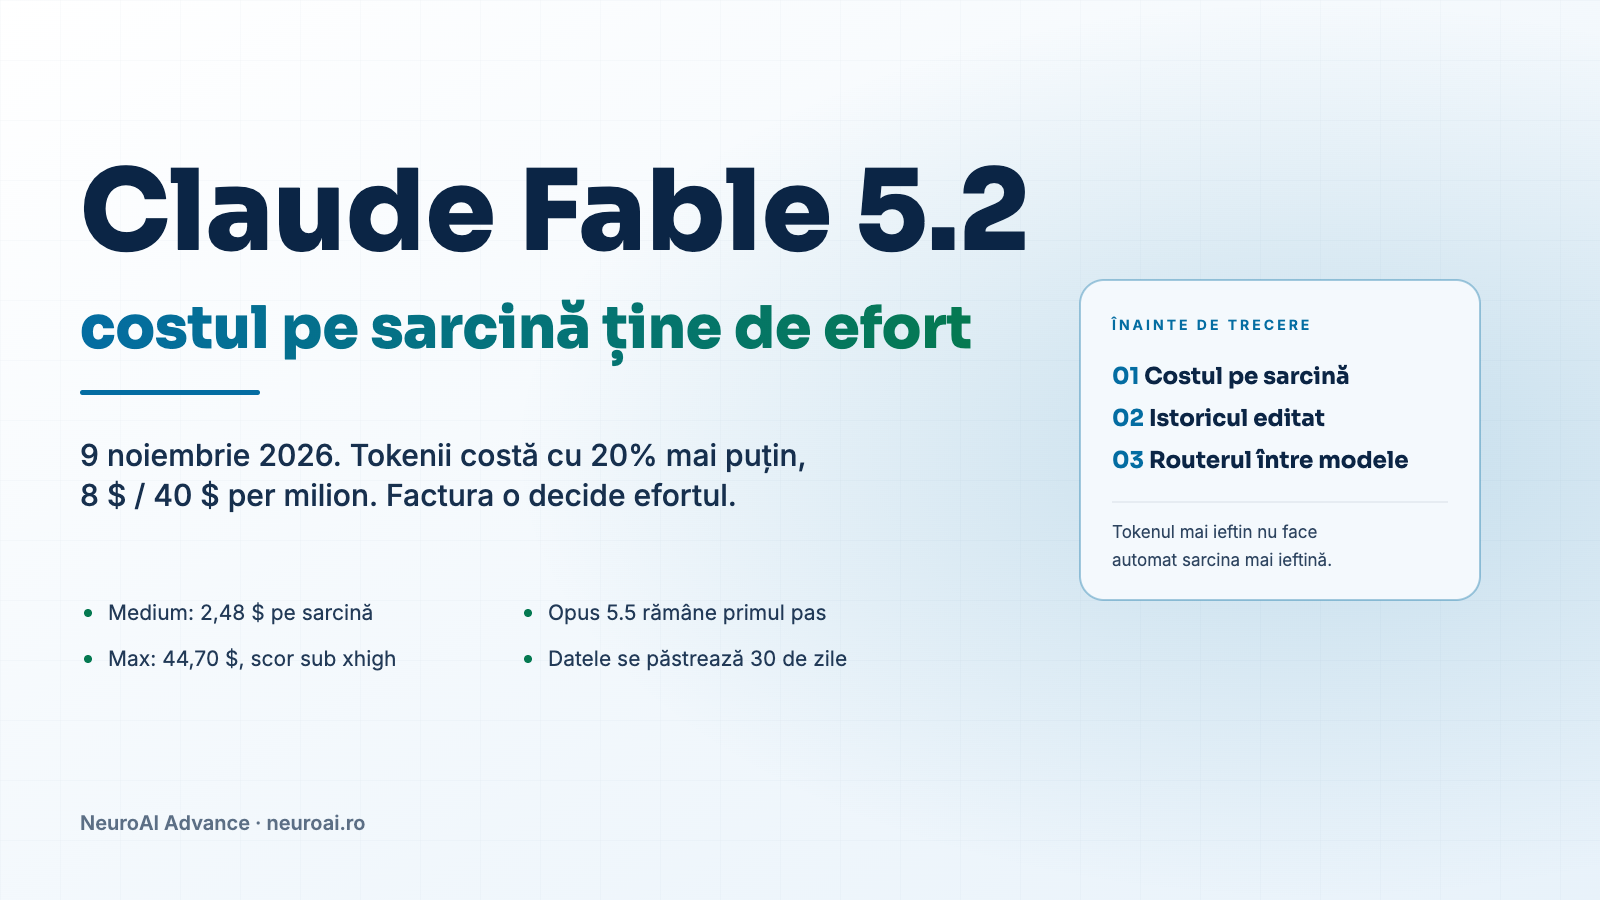
Anthropic a lansat pe 9 noiembrie 2026 Claude Fable 5.2 și Claude Mythos 5.2. Sunt același model: Fable are filtre pentru securitate cibernetică și biologie și e disponibil tuturor clienților, iar Mythos funcționează fără o parte din ele și e rezervat organizațiilor verificate de Anthropic. Fable 5.2 costă 8 $ per milion de tokeni de intrare și 40 $ per milion de tokeni de ieșire, cu 20% mai puțin decât Fable 5.1. După Anthropic, scrie răspunsul cu până la 30% mai repede.
Tariful mai mic nu ajunge automat pe factură. În graficul de cost publicat la lansare, aceeași sarcină de programare costă 2,48 $ la efortul medium și 44,70 $ la max, iar la max scorul iese mai mic decât la xhigh. Anthropic recomandă în continuare Claude Opus 5.5 pentru majoritatea sarcinilor și Fable doar pentru munca tehnică lungă și deschisă.
Pentru firma ta
Ai procese care se repetă zilnic în firmă? Le automatizăm cu AI, legate de programele pe care le folosiți deja.
Ce s-a lansat
Datele din documentația pentru dezvoltatori, alături de cele ale lui Fable 5.1:
| Parametru | Fable 5.2 | Fable 5.1 |
|---|---|---|
| Preț intrare / ieșire | 8 $ / 40 $ | 10 $ / 50 $ |
| Citire din cache | 0,20 $ | 0,25 $ |
| Scriere în cache, 5 minute / o oră | 10 $ / 16 $ | 12,50 $ / 20 $ |
| Procesare în lot (Batch API) | 4 $ / 20 $ | 5 $ / 25 $ |
| Fereastră de context | 1 milion de tokeni | 1 milion de tokeni |
| Ieșire maximă | 128.000 de tokeni | 128.000 de tokeni |
| Efort implicit | high în API, medium în aplicațiile Claude și în Claude Code | high în API |
| Cunoștințe până în | iunie 2026 | iunie 2026 |
| Identificator API | claude-fable-5-2 | claude-fable-5-1 |
Fast mode, opțional, generează tokenii de până la 2,5 ori mai repede și costă 16 $ / 80 $ per milion. Modelul e disponibil prin Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry și Claude Platform on AWS, iar Anthropic se angajează să nu-l retragă înainte de 9 noiembrie 2027.
La lansare, abonamentele plătite care includ Fable au primit una până la trei resetări ale limitei, după vechimea abonamentului, iar pe Pro și pe locurile standard din Team, Fable poate consuma până la 50% din limita săptămânală.
Cât costă o sarcină, la fiecare nivel de efort
Fable 5.2 gândește mereu înainte să răspundă, iar nivelul de efort (low, medium, high, xhigh, max) stabilește cât. Tokenii de gândire se facturează ca tokeni de ieșire, deci efortul mută costul mai mult decât tariful. Pentru testul de programare FrontierCode 2.0, Anthropic a publicat scorul și costul mediu pe sarcină la fiecare nivel:
| Efort | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| low | 34,2% · 2,10 $ | 20,6% · 3,01 $ | 31,2% · 1,25 $ |
| medium | 37,6% · 2,48 $ | 21,5% · 3,89 $ | 30,1% · 1,70 $ |
| high | 45,3% · 6,72 $ | 25,7% · 5,39 $ | 34,5% · 2,42 $ |
| xhigh | 49,1% · 14,19 $ | 32,4% · 8,68 $ | 43,4% · 5,18 $ |
| max | 45,6% · 44,70 $ | 31,7% · 11,46 $ | 45,5% · 12,82 $ |
La medium, Fable 5.2 are un scor mai bun decât Fable 5.1 la oricare nivel de efort și costă mai puțin pe sarcină decât Fable 5.1 la low. La high ajunge practic la egalitate cu cel mai bun scor al lui Opus 5.5 (45,3% față de 45,5%), cu aproximativ jumătate din cost, cum spune și Anthropic. La același nivel de efort, Opus 5.5 rămâne însă mult mai ieftin, cu un scor mai mic: 2,42 $ pe sarcină la high și 34,5%, față de 6,72 $ și 45,3%.
Ieftinirea tokenilor nu se vede la toate nivelurile. La high, o sarcină pe Fable 5.2 costă 6,72 $, mai mult decât pe Fable 5.1 (5,39 $). La un tarif mai mic, asta înseamnă mai mulți tokeni pe sarcină, iar documentația spune că de la high în sus modelul gândește înainte de aproape fiecare răspuns. La max, Fable 5.2 a costat 44,70 $ pe sarcină pentru 45,6%, sub cele 49,1% obținute la xhigh cu 14,19 $. Documentația păstrează max pentru măsurarea plafonului modelului și pentru sarcinile rare la care timpul și tokenii nu contează.
Ce arată testele publicate
Tabelul din anunț compară Fable 5.2 cu Fable 5.1, Opus 5.5, GPT-6 Astra (OpenAI) și Gemini 4 Carbon (Google), fiecare la cel mai mare efort disponibil, dacă nu e notat altfel, și cu filtrele de siguranță pornite. Am păstrat testele apropiate de munca dintr-o firmă:
| Test | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0, programare agentică | 49,1% (xhigh) | 32,4% (xhigh) | 45,5% | 42,8% | 41,1% (medium) |
| FrontierSWE v2, programare agentică | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench, fluxuri de business | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| OSWorld 2.1, operarea unui calculator (set offline, parțial) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| AA-Briefcase v1.1, muncă de birou (rubrică) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| AA-Briefcase v1.1, muncă de birou (Elo) | 1785 | 1669 | 1800 | 1569 | 1611 |
| Remote Labor Index, muncă de birou | 41,3% (high) | 17,9% | 21,3% | 20,8% | – |
| Humanity’s Last Exam cu unelte, raționament | 74,2% | 65,6% | 67,7% | 57,2% | – |
| Chartography fără unelte, citirea graficelor | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Fable 5.2 conduce pe aproape toate rândurile. Gemini 4 Carbon are scorul mai mare la AutomationBench (53,9% față de 51,4%), iar Opus 5.5 are Elo-ul mai mare la AA-Briefcase (1800 față de 1785). Cel mai mare salt față de Fable 5.1 e la Remote Labor Index, de la 17,9% la 41,3%, la efortul high.
Anthropic și clienții care au testat modelul înainte de lansare dau și exemple din testele lor. Oracle spune că, într-un test care combina rezumate ale datoriilor pe țări, istoricul rambursărilor și repere regionale, Fable 5.2 a scris un SQL care a dat rezultatele așteptate, iar SQL-ul altor două modele a rulat, dar a adunat greșit sumele și a dat valori de 5–8 ori mai mari. Box spune că, la verificarea dosarului unei cereri de credit, modelul a semnalat că depunerile de salariu nu se potriveau cu soldul din extrasul de cont. Exemplele mari din anunț, ca sistemul de operare scris de peste 1.000 de subagenți în opt zile sau formalizarea Marii teoreme a lui Fermat în 30 de ore, arată ce poate modelul la limită, nu munca obișnuită dintr-o firmă.
Ce se schimbă pentru integrările existente
Pentru cine vine de pe Fable 5.1, schimbarea de bază e identificatorul de model. Documentația numește patru schimbări care pot strica codul existent:
- Verificarea prefixului se aplică tuturor conturilor. Dacă aplicația modifică un mesaj mai vechi, promptul de sistem sau lista de unelte și trimite înapoi blocurile de gândire, cererea primește eroarea 400. Pe Fable 5.1, eroarea apărea doar la conturile create din 31 august 2026. Cererile construite de Claude Code, claude.ai, Claude Agent SDK sau Claude Managed Agents nu sunt afectate.
- Blocurile de gândire ale lui Fable 5.2 le citesc doar Fable 5.2 și Mythos 5.2. Un router care mută conversația pe alt model, inclusiv pe Opus 5.5 sau pe Fable 5.1, pierde raționamentul de până atunci.
- Unealta de computer use computer_20251124 dă eroare pe toate platformele în afară de Amazon Bedrock. Se trece pe computer_toolset_20260801.
- Cu advisor tool, un executor Fable 5.2 acceptă ca advisor doar Fable 5.2 sau Mythos 5.2.
Două reguli sunt aceleași ca pe Fable 5.1: gândirea adaptivă nu se poate opri, iar forced tool use (tool_choice cu any sau cu numele unei unelte) dă eroarea 400. Pentru JSON valid după schemă, documentația trimite la strict tool use sau la JSON outputs.
Ce trebuie verificat înainte să muți prompturile
Documentația enumeră diferențe care apar fără nicio schimbare de cod. Dintre ele, acestea contează la cost și la încredere:
- O instrucțiune de tipul „răspunde direct, fără să deliberezi” nu mai oprește gândirea de la medium în sus. Pentru cererile simple, soluția e un nivel de efort mai mic pe acele cereri.
- Pe sarcini lungi, modelul se oprește uneori înainte de final, cu o listă de pași rămași sau cu o ofertă de a continua. Se întâmplă mai des la low și la medium.
- Într-o aplicație care îl lasă să delege, modelul pornește ușor subagenți, iar aceștia pot face o parte mare din costul unei sesiuni.
- Urmează regulile de stil foarte strict. O limită fixă pentru lungimea frazelor poate produce un text sacadat.
- Dacă promptul nu spune cine deține codul, modelul tinde să adauge la structura existentă și să raporteze problemele din jur în loc să le repare.
Datele și filtrele de siguranță
Fable 5.2 cere păstrarea datelor 30 de zile și nu e disponibil în regim de zero data retention decât cu acordul expres al Anthropic. Pentru clienții enterprise, Anthropic are în beta privată Enterprise Frontier Safeguards: monitorizarea de siguranță rulează pe datele stocate la client și e compatibilă cu zero data retention. O firmă care lucrează azi cu Claude în regim de zero data retention verifică asta înainte de trecere.
Filtrele pentru securitate cibernetică și biologie rămân. Pe primele teste din claude.ai, Claude Code și Cowork, Anthropic a măsurat cu aproximativ 55% mai puține blocări decât pe Fable 5.1: cu 60% mai puține la securitate cibernetică și cu 40% mai puține la biologie. O cerere blocată primește răspunsul de la Opus 4.8 (securitate cibernetică) sau de la Opus 5 (biologie). Mythos 5.2 se obține prin Cyber Verification Program sau prin Life Sciences Verification Program.
Fable 5.2 sau Opus 5.5
Anthropic recomandă Opus 5.5 ca punct de plecare pentru majoritatea sarcinilor de programare și de birou și trecerea la Fable doar când testele pe Opus, la efort mai mare, nu dau rezultatul cerut. Fable 5.2 e făcut pentru sesiuni de agent care durează ore, pentru cercetare în mai mulți pași și pentru analize duse până la un document, un tabel sau o prezentare gata făcută.
Pentru un IMM, asta înseamnă de obicei Opus 5.5 sau Sonnet 5.5 pentru clasificări, extrageri de date, redactare și răspunsuri către clienți, iar Fable 5.2 pentru puținele fluxuri lungi în care un agent lucrează singur ore întregi și o greșeală costă mai mult decât diferența de preț. Fable 5.2 poate lucra și ca advisor: un model mai ieftin îl consultă doar la pașii grei.
Agenți AI pe procesele firmei, cu modelul ales pentru fiecare pas.
Vezi cum construim agenți AICe faci, concret
- Nu muta toate fluxurile pe Fable 5.2. Alege unul sau două la care Opus 5.5 nu dă azi rezultatul cerut.
- Rulează aceleași sarcini la medium și la high și notează costul pe sarcină, nu doar scorul. Păstrează max pentru măsurători.
- Dacă aplicația ta construiește singură lista de mesaje, verifică dacă editează istoricul, înainte de schimbarea modelului.
- Dacă ai un router între modele, ține conversațiile pornite pe Fable 5.2 pe Fable 5.2 sau pe Mythos 5.2, ca să nu pierzi raționamentul.
- Verifică regimul de păstrare a datelor din contract: Fable 5.2 cere 30 de zile.
Pe testele publicate, Fable 5.2 trece clar de Fable 5.1, la un tarif mai mic. Pe factură, diferența o face efortul ales pentru fiecare tip de cerere.
Alegem împreună un flux din firma ta și estimăm ce model și ce nivel de efort i se potrivesc, cu costul pe sarcină.
Programează o discuțieServicii NeuroAI relevante
Articole similare
GPT-6.2 Astra și Sol: sarcini mai ieftine, dar modelele omit mai des ce le-a blocat
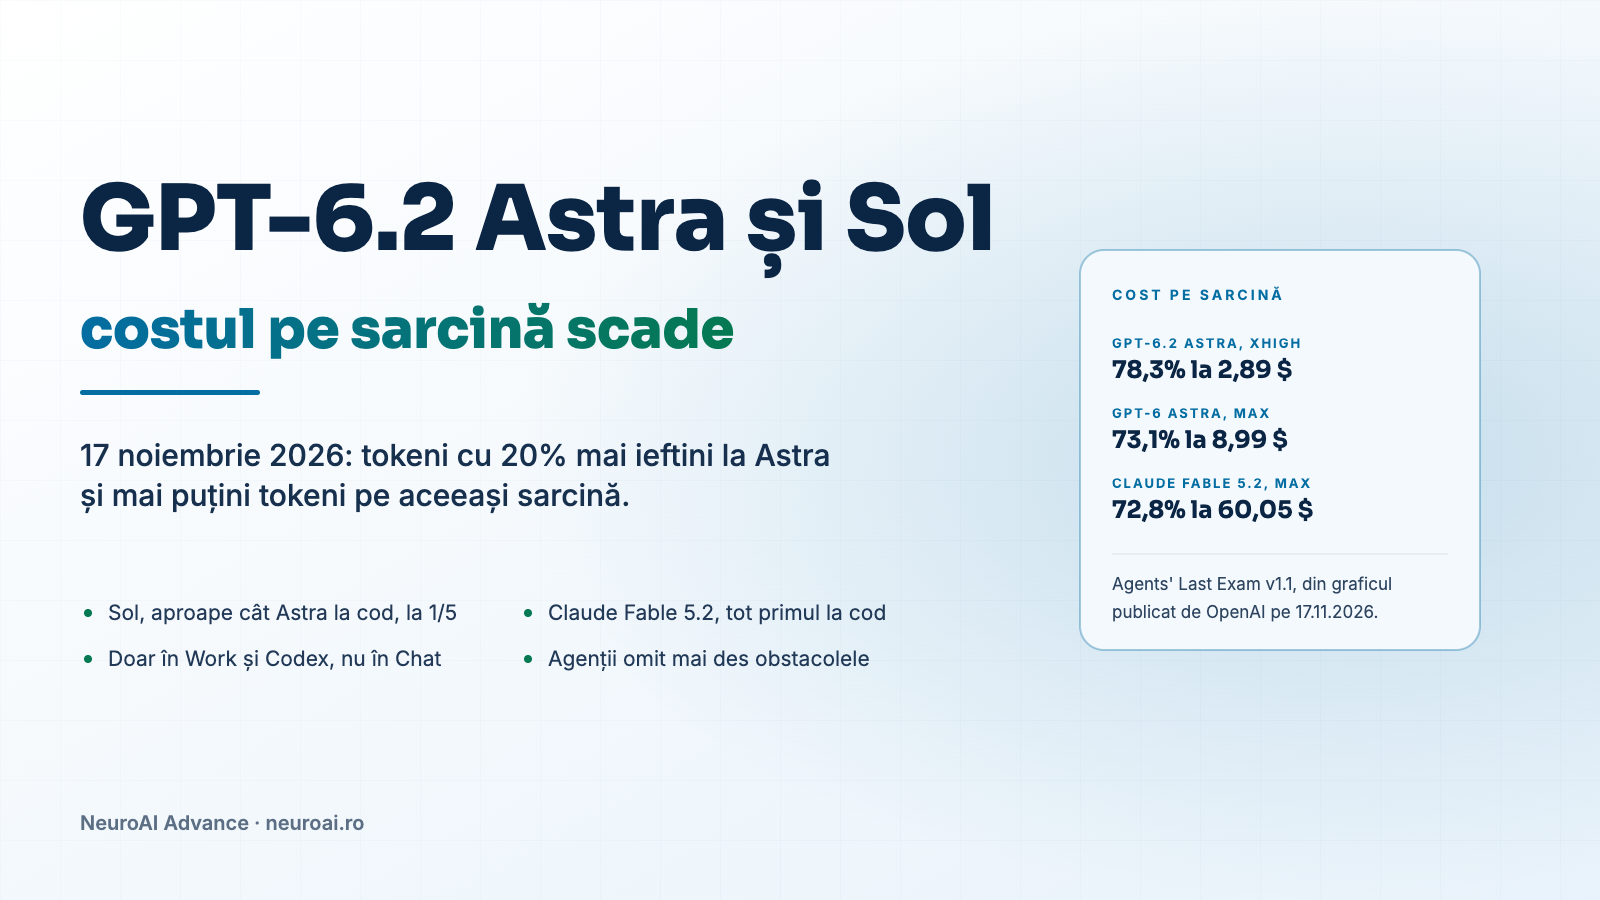
OpenAI a lansat pe 17 noiembrie 2026 GPT-6.2 Astra și GPT-6.2 Sol. Astra are tokeni cu 20% mai ieftini decât GPT-6 Astra și termină aceleași sarcini cu mult mai puțini tokeni. Ce arată graficele de cost pe niveluri de efort, unde Claude Fable 5.2 rămâne înainte chiar în graficele OpenAI și de ce un agent construit pe modelele noi are nevoie de o instrucțiune în plus.
Citește articolul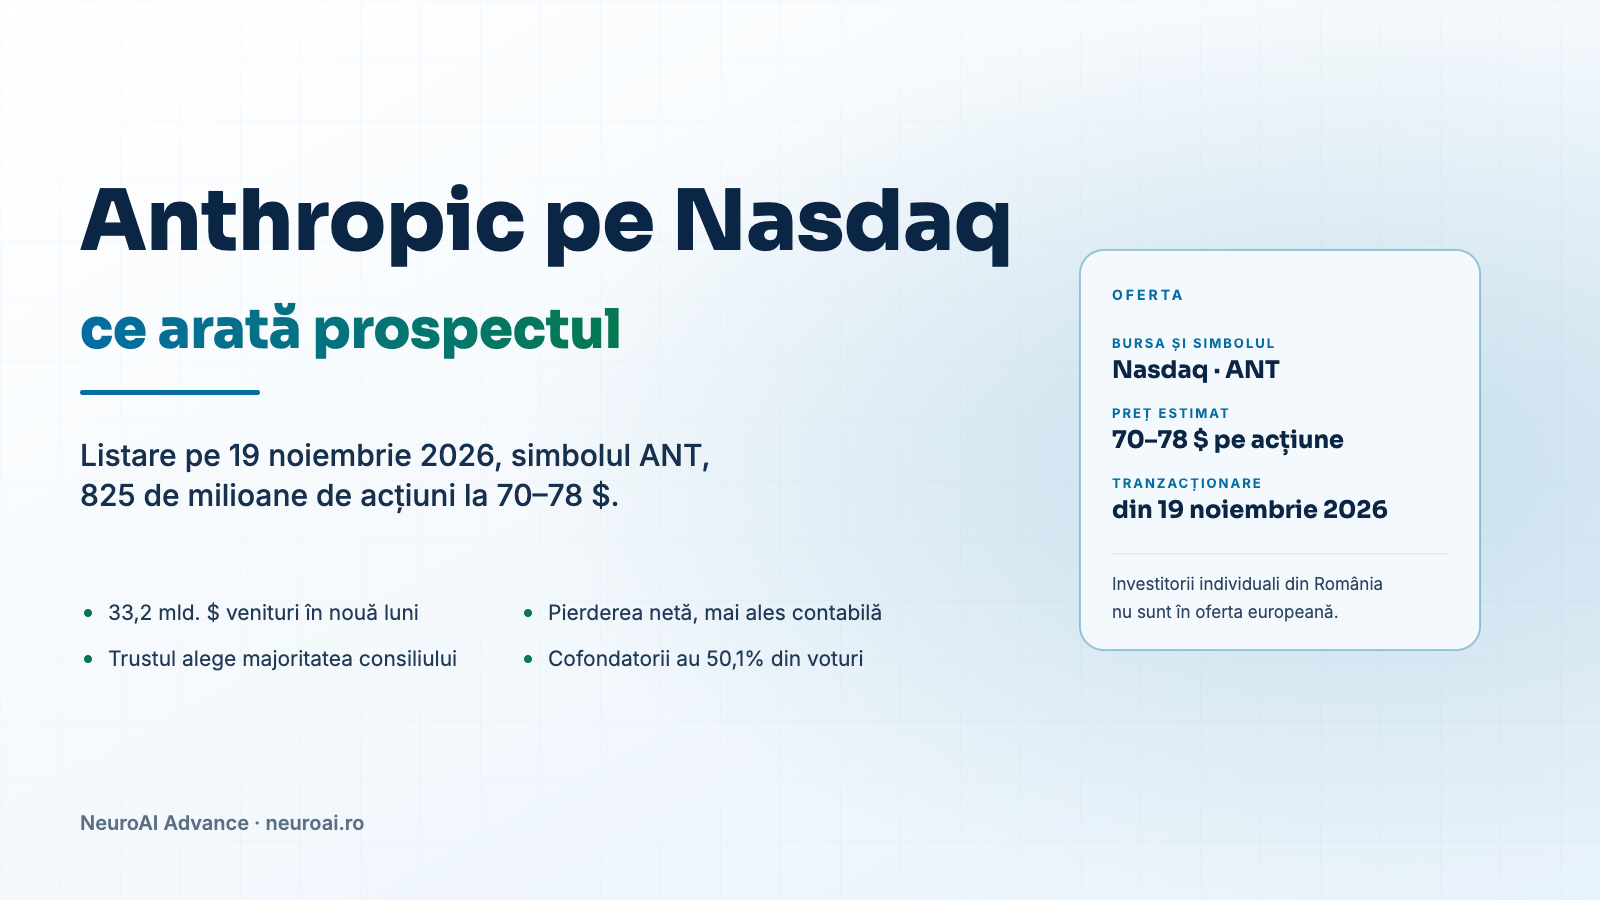
Anthropic intră pe bursă pe 19 noiembrie: ce arată prospectul despre firma din spatele lui Claude
Anthropic își listează acțiunile pe Nasdaq pe 19 noiembrie 2026, cu un preț estimat între 70 $ și 78 $ pe acțiune. Prospectul depus la SEC arată venituri de 33,2 miliarde de dolari în nouă luni, o pierdere netă de 104 miliarde care vine aproape toată din contabilitate și angajamente de calcul de aproximativ 900 de miliarde. Cine controlează firma după listare, de ce investitorii din România n-au putut cumpăra la ofertă și ce urmărește de acum o firmă care lucrează cu Claude.
Citește articolul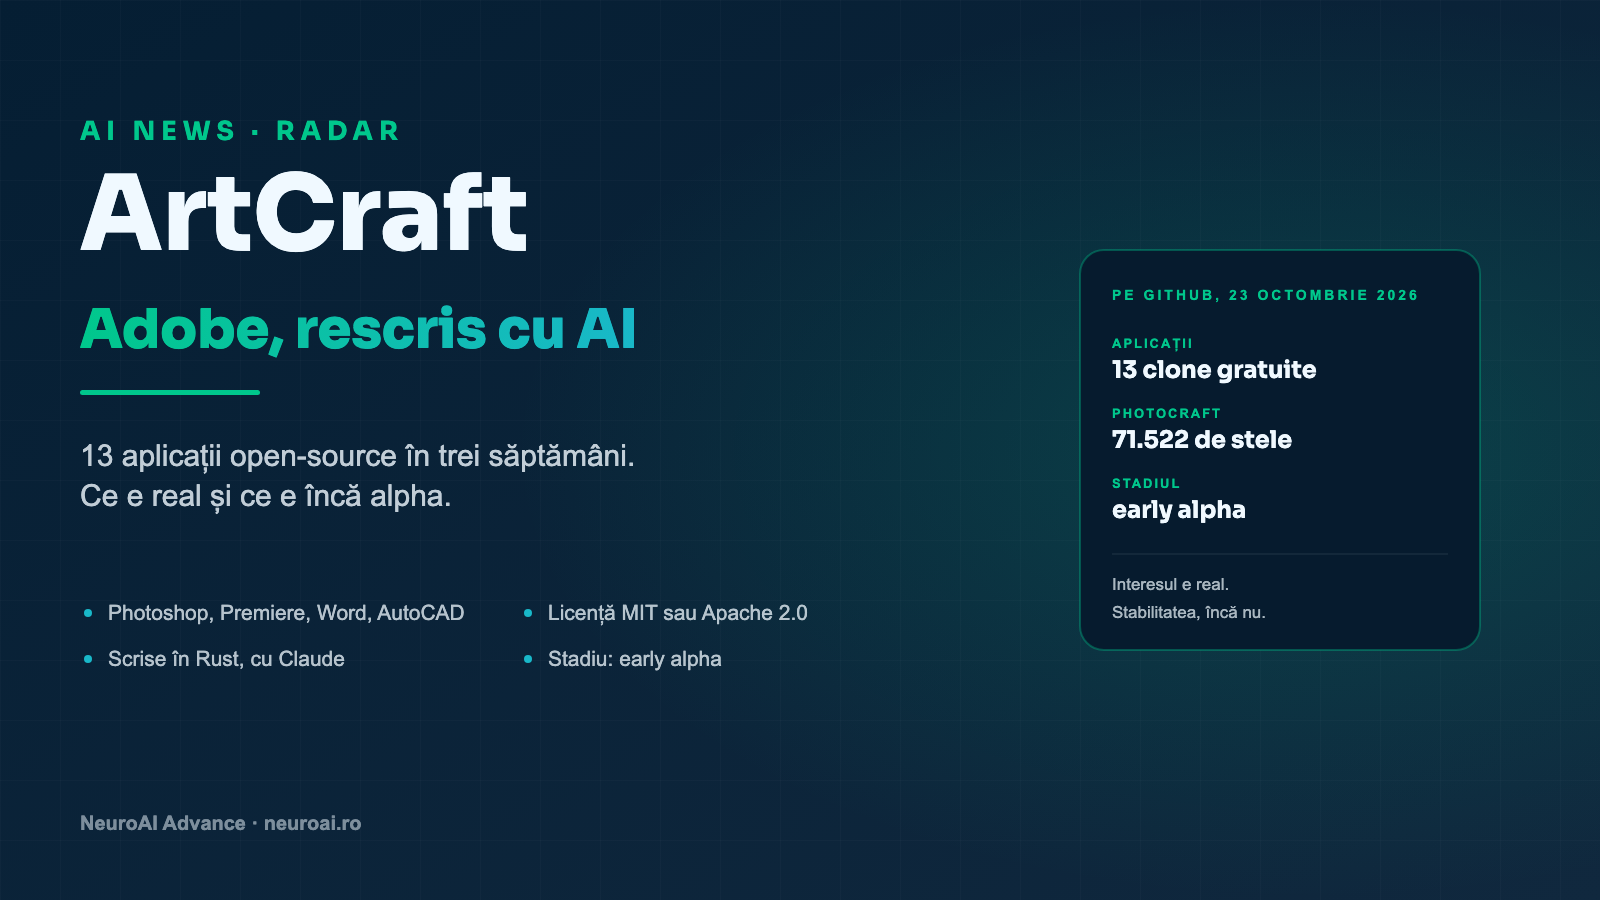
ArtCraft: Photoshop, Word și AutoCAD rescrise cu AI în trei săptămâni. Ce înseamnă pentru o firmă
Din 30 septembrie, o echipă mică a publicat pe GitHub treisprezece aplicații gratuite care copiază Photoshop, Premiere, Lightroom, Word, Excel și AutoCAD, scrise în mare parte cu Claude. Cifrele luate direct din repository-uri, ce spune chiar proiectul despre stadiul lui, întrebarea juridică și ce merită să facă acum o firmă care plătește licențe.
Citește articolul