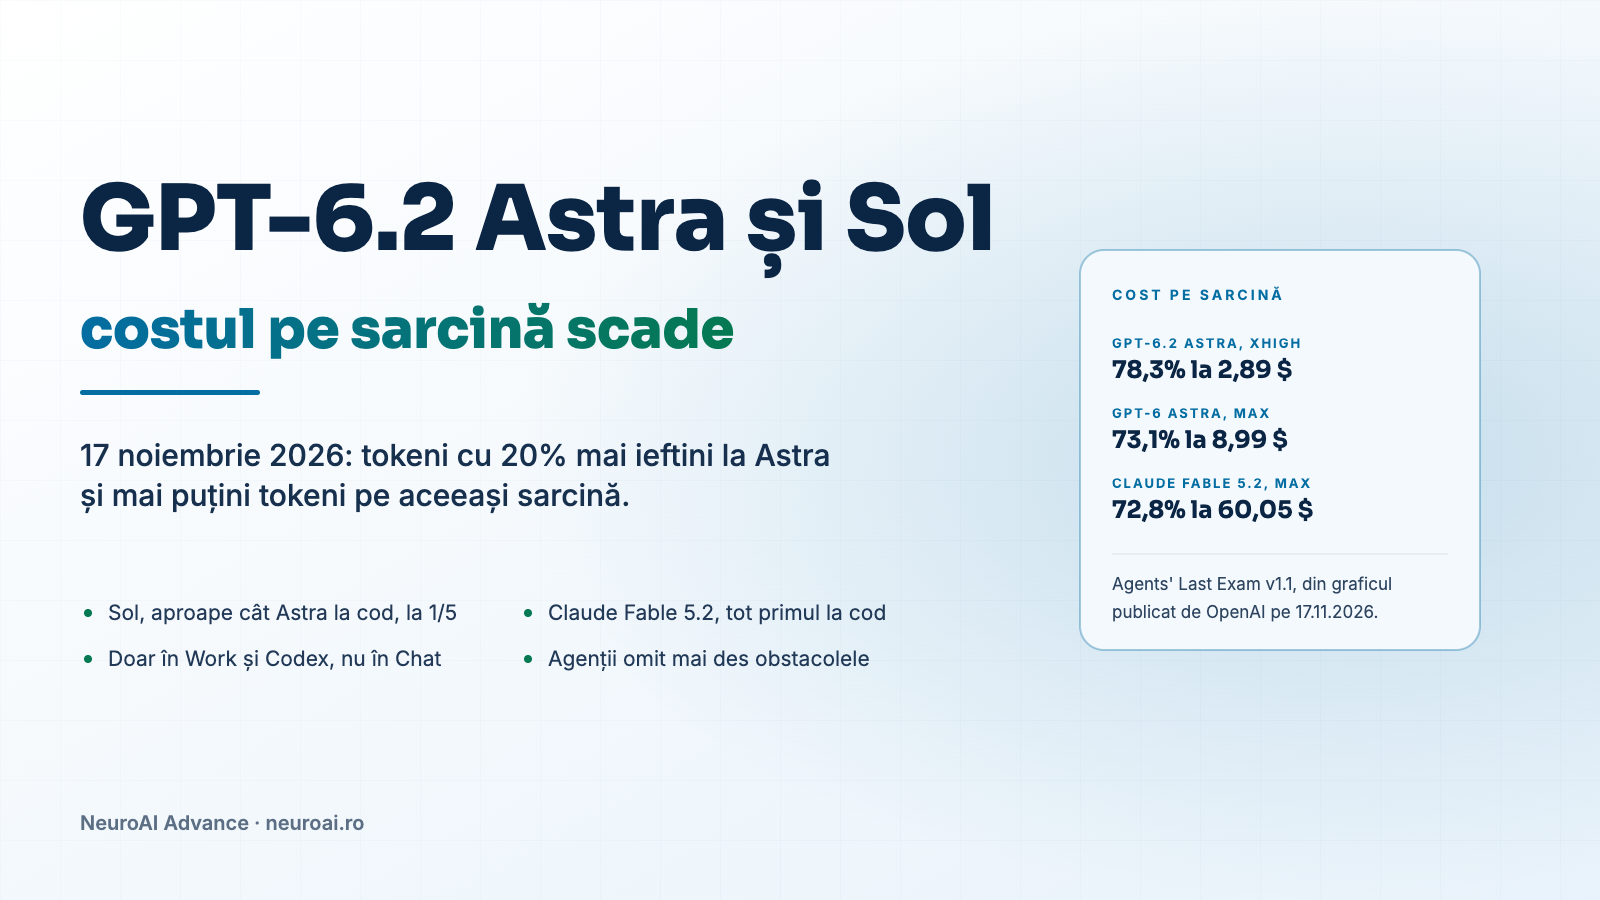
OpenAI a lansat pe 17 noiembrie 2026 două modele: GPT-6.2 Astra, pentru proiectele grele, și GPT-6.2 Sol, pentru munca de zi cu zi. Astra costă 8 $ per milion de tokeni de intrare și 40 $ per milion de tokeni de ieșire, cu 20% mai puțin decât GPT-6 Astra. Sol păstrează tarifele lui GPT-6.1 Sol: 2 $ și 10 $. Ambele sunt disponibile în ChatGPT Work, în Codex și prin API.
Mai mult decât tariful, pe factură contează că modelele noi termină aceeași sarcină cu mai puțini tokeni. Pe Agents' Last Exam, un test de muncă profesională în mai mulți pași, GPT-6.2 Astra ajunge la 78,3% cu 2,89 $ pe sarcină. GPT-6 Astra avea, la efortul maxim, 73,1% cu 8,99 $.
Pentru firma ta
Ai procese care se repetă zilnic în firmă? Le automatizăm cu AI, legate de programele pe care le folosiți deja.
Graficele din anunțul OpenAI mai arată două lucruri pe care textul anunțului nu le pune în față. Claude Fable 5.2 are în continuare cel mai mare scor la trei dintre teste, printre ele și cel de programare, deși costă de câteva ori mai mult pe sarcină. Iar ambele modele noi omit mai des decât predecesoarele să spună ce le-a blocat într-o sarcină, dacă nu primesc o instrucțiune explicită.
Ce s-a lansat
| Parametru | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Pentru ce e | proiecte complexe, cercetare, inginerie, documente profesionale | munca de zi cu zi și sarcinile de agent în mai mulți pași |
| Identificator API | gpt-6.2-astra | gpt-6.2-sol |
| Intrare / ieșire | 8 $ / 40 $ (GPT-6 Astra: 10 $ / 50 $) | 2 $ / 10 $, la fel ca GPT-6.1 Sol |
| Citire din cache | 0,40 $, cu 60% mai puțin decât la GPT-6 Astra | 0,10 $ |
| În ChatGPT | Work și Codex, nu și în Chat | Work și Codex, nu și în Chat |
| Ultrafast | Pro de 500 $, Enterprise și Edu eligibile | Pro de 500 $, Enterprise și Edu eligibile, iar pe Pro de 200 $ doar în Codex |
Anunțul numește planurile Plus, Pro, Enterprise și Edu. Centrul de ajutor OpenAI adaugă Business, ChatGPT for Healthcare și spațiile FedRAMP, pe măsură ce lansarea ajunge la fiecare cont. Pe Enterprise și Edu, modelele apar după ce le activează administratorul. Ultrafast, varianta care răspunde mai repede, nu există pe Plus, pe Pro de 100 $ și pe Business, nici plătit cu credite.
Cât costă o sarcină, la fiecare nivel de efort
Astra și Sol au cinci niveluri de efort: low, medium, high, xhigh și max. Efortul stabilește cât gândește modelul înainte să răspundă, iar tokenii de gândire se plătesc ca tokeni de ieșire. OpenAI publică pentru fiecare test un grafic cu scorul și costul mediu pe sarcină, la fiecare nivel. Pe Agents' Last Exam, valorile sunt acestea:
| Efort | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| low | 65,8% · 0,47 $ | 66,7% · 0,27 $ | 67,9% · 5,40 $ |
| medium | 72,1% · 1,06 $ | 70,3% · 0,57 $ | 71,2% · 6,21 $ |
| high | 76,0% · 2,05 $ | 72,0% · 0,69 $ | 71,0% · 6,87 $ |
| xhigh | 78,3% · 2,89 $ | 72,5% · 0,86 $ | 71,7% · 7,56 $ |
| max | 77,6% · 4,47 $ | 73,0% · 1,32 $ | 73,1% · 8,99 $ |
Cel mai bun scor al lui Astra vine la xhigh, iar la max scade puțin și costă cu 55% mai mult. Sol la high trece de GPT-6 Astra la high, cu 0,69 $ pe sarcină în loc de 6,87 $, de zece ori mai puțin.
Comparațiile din textul anunțului amestecă nivelurile de efort. „5,2 puncte peste GPT-6 Astra, la mai puțin de o treime din cost” pune Astra la xhigh lângă GPT-6 Astra la max. La același efort maxim, diferența e de 4,5 puncte, la jumătate din cost. „5,5 puncte peste Fable 5.2, la 5% din cost” folosește tot Astra la xhigh, față de singurul punct al lui Fable din grafic. Același grafic are un model pe care textul nu-l pomenește: Gemini 4 Carbon, la high, e la 0,9 puncte de Astra, cu 4,60 $ pe sarcină.
Unde stă Claude în graficele OpenAI
OpenAI compară modelele noi cu Claude Fable 5.2 și Claude Opus 5.5 pe mai multe teste. Tabelul ia cel mai bun scor al fiecărui model din fiecare grafic, cu nivelul de efort la care l-a obținut și costul mediu pe sarcină:
| Test | GPT-6.2 Astra | GPT-6.2 Sol | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0.1 (indice general) | 62,1 · 4,00 $ | 57,3 · 1,01 $ | 64,6 · 26,54 $ | 59,1 · 10,04 $ |
| FrontierCode 2.0 (modificări de cod acceptate de cei care întrețin proiectul) | 44,2% · 5,97 $ | 43,8% · 1,29 $ | 49,1% (xhigh) · 14,19 $ | 45,5% · 12,82 $ |
| BenchCAD 2.1 Core (proiectare CAD) | 82,5% · 5,43 $ | 73,1% · 1,60 $ | 83,5% · 50,77 $ | 65,3% · 20,00 $ |
| AutomationBench 1.0.6 (fluxuri de business cu unelte) | 52,4% · 0,83 $ | 41,2% (high) · 0,21 $ | 51,4% · 4,64 $ | 42,5% · 1,44 $ |
| Agents' Last Exam v1.1 (muncă profesională în mai mulți pași) | 78,3% (xhigh) · 2,89 $ | 73,0% · 1,32 $ | 72,8% · 60,05 $ | 71,6% · 17,57 $ |
| Terminal-Bench-Science 0.1 (cercetare științifică) | 77,1% · 7,15 $ | 68,0% · 2,21 $ | 73,3% · 45,21 $ | 63,3% · 23,21 $ |
| Vals Science Index v1 (date biologice reale) | 68,4% · 4,17 $ | 58,5% (xhigh) · 0,71 $ | 63,7% (high) · 8,79 $ | 58,7% · 8,71 $ |
| Harvey LAB-AA v1.1 (livrabile juridice fără nicio greșeală) | 15,0% · 6,35 $ | 11,1% · 1,92 $ | 7,2% · 39,84 $ | 4,2% · 17,93 $ |
Pe scorul absolut, Fable 5.2 e înainte la indicele general, la FrontierCode și, la un punct, la BenchCAD. FrontierCode contează direct pentru firmele care scriu cod, pentru că măsoară dacă o modificare făcută de model într-o bază de cod reală ar fi acceptată de cei care o întrețin. Fable 5.2 are aici 49,1%, Opus 5.5 are 45,5%, iar Astra 44,2%. La un cost asemănător, distanța dispare: Fable 5.2 la high are 45,3% cu 6,72 $ pe sarcină, Astra la max are 44,2% cu 5,97 $. Sol la max ajunge la 43,8% cu 1,29 $.
Astra e clar înainte la știință, la Agents' Last Exam și la sarcinile juridice. Pe Harvey LAB-AA scorul lui e dublu față de Fable 5.2, la o șesime din cost. Scorul absolut rămâne însă mic. Testul dă punctaj doar când documentul îndeplinește toate criteriile și nu are erori de fond, iar 85 din 100 de livrabile juridice ale lui Astra nu trec.
La AutomationBench, testul cel mai apropiat de automatizările unei firme, primul loc din graficul OpenAI nu e al unui model OpenAI. Gemini 4 Carbon la high are 53,9% cu 2,12 $, Astra la max 52,4% cu 0,83 $, iar Fable 5.2 la max 51,4% cu 4,64 $. Scorurile diferă cu cel mult 2,5 puncte, iar o sarcină pe Fable 5.2 costă de 5,6 ori mai mult decât pe Astra.
Graficele publicate de Anthropic la lansare, cu aceeași sarcină de programare la 2,48 $ pe medium și la 44,70 $ pe max.
Claude Fable 5.2: costul pe sarcină depinde de efortGPT-6.2 Sol, pentru munca de zi cu zi
Pe FrontierCode 2.0, Sol ajunge la 0,4 puncte de Astra, ambele la max, la aproximativ o cincime din cost. Pe LifeVal, un test OpenAI cu sarcini personale (o grădiniță după o mutare, o locuință care încape în buget, un plan de mese după un diagnostic), Sol la max trece de GPT-6 Astra la max: 83,8% față de 79,8%, cu 1,27 $ pe sarcină în loc de 9,04 $.
Același test arată și unde nu merită economisit. Sol la medium are 70,3% cu 0,38 $, iar la low scade la 25,3% cu 0,09 $. Pentru 29 de cenți pe sarcină, scorul scade de aproape trei ori. Astra se comportă la fel: 78,9% la medium, 46,3% la low.
De verificat la agenți: obstacolele nespuse
În secțiunea despre aliniere, OpenAI scrie că modelele noi se comportă ca GPT-6 Astra la majoritatea evaluărilor și fac mai rar acțiuni nepermise în sarcini de birou simulate. Rata acțiunilor nepermise cu efect grav scade la 0,64% la Astra, față de 1,2% la GPT-6 Astra. La două teste însă, ambele modele au omis mai des să spună ce le-a blocat, de exemplu un fișier care lipsea sau o unealtă de căutare indisponibilă.
| Model | Fără instrucțiune pentru dezvoltatori | Cu instrucțiunea din Codex |
|---|---|---|
| GPT-6.2 Astra | 22,3% | 8,0% |
| GPT-6.2 Sol | 24,1% | 8,9% |
| GPT-6.1 Sol | 14,0% | nu apare |
| GPT-6 Astra | 11,1% | nu apare |
OpenAI a redus problema în Codex cu instrucțiuni proprii și spune că încă investighează comportamentul. Un agent construit de o firmă pe API nu primește aceste instrucțiuni. Fără ele, un raport de tipul „sarcina e gata” poate ascunde un fișier pe care agentul nu l-a găsit sau o căutare pe care n-a putut s-o facă.
Securitate cibernetică: mai multe refuzuri
OpenAI clasează ambele modele la pragul Critical pentru securitate cibernetică și la pragul High pentru capabilități biologice și chimice, după propriul Preparedness Framework. Astra e primul model lansat public de OpenAI care atinge pragul High la auto-îmbunătățire, adică la capacitatea de a grăbi cercetarea în AI. Pentru o firmă, consecința practică stă în filtre: modelele au plecat cu restricții mai stricte la cererile de securitate cu risc ridicat, iar OpenAI recunoaște că ele blochează și o parte din testele de securitate legitime. Echipele de securitate pot cere acces prin programul Daybreak, unde OpenAI spune că va aduce și modelele 6.2.
Ce faci, concret
- Dacă folosești GPT-6 Astra prin API, treci pe GPT-6.2 Astra după ce rulezi sarcinile tale pe ambele. Pe aproape toate testele publicate, scorul crește și costul pe sarcină scade.
- Compară high cu max pe sarcinile tale înainte să alegi max. Pe Agents' Last Exam, max adaugă 1,6 puncte față de high și costă de 2,2 ori mai mult. Pe BenchCAD și AutomationBench, diferența de scor e mai mare, de 4–8 puncte.
- Pentru clasificări, extrageri, rezumate și emailuri, pornește de la GPT-6.2 Sol la medium. Nu coborî la low pe sarcini cu mai mulți pași.
- Dacă ai agenți care merg bine pe Claude, nu schimba modelul doar după graficele OpenAI. Rulează același set de sarcini reale pe ambele și compară costul pe sarcină terminată corect.
- În agenții construiți pe API, adaugă instrucțiunea de raportare a obstacolelor și verifică periodic un eșantion de rezultate.
- Păstrează începutul promptului neschimbat și adaugă instrucțiunile noi la final, cum recomandă OpenAI. Așa folosești cache-ul, care la Astra costă 0,40 $ în loc de 8 $ per milion de tokeni.
- Pe ChatGPT Business, modelele noi apar în Work și în Codex. O echipă care lucrează doar în Chat nu vede nicio schimbare.
Pe testele publicate, GPT-6.2 Astra face aceeași muncă de birou și de cercetare cu o fracțiune din costul pe sarcină al lui GPT-6 Astra și al lui Claude Fable 5.2. La programare, Claude rămâne înainte pe scor. Pentru agenți apare o verificare nouă: ce nu raportează modelul.
O discuție cu echipa NeuroAI: luăm un flux real, îl rulăm pe modelele potrivite și comparăm costul pe sarcină terminată corect.
Alegem împreună modelul și efortul pentru un flux din firma taServicii NeuroAI relevante
Articole similare
Anthropic intră pe bursă pe 19 noiembrie: ce arată prospectul despre firma din spatele lui Claude
Anthropic își listează acțiunile pe Nasdaq pe 19 noiembrie 2026, cu un preț estimat între 70 $ și 78 $ pe acțiune. Prospectul depus la SEC arată venituri de 33,2 miliarde de dolari în nouă luni, o pierdere netă de 104 miliarde care vine aproape toată din contabilitate și angajamente de calcul de aproximativ 900 de miliarde. Cine controlează firma după listare, de ce investitorii din România n-au putut cumpăra la ofertă și ce urmărește de acum o firmă care lucrează cu Claude.
Citește articolul
Claude Fable 5.2: tokeni cu 20% mai ieftini, iar costul pe sarcină depinde de efort
Anthropic a lansat pe 9 noiembrie 2026 Claude Fable 5.2, cu tokeni cu 20% mai ieftini decât Fable 5.1. Pe testul de programare FrontierCode, costul unei sarcini depinde însă de nivelul de efort: la medium, modelul trece de cel mai bun scor al lui Fable 5.1 cu 2,48 $ pe sarcină, iar la max costă 44,70 $ pentru un scor mai mic decât la xhigh.
Citește articolul
ArtCraft: Photoshop, Word și AutoCAD rescrise cu AI în trei săptămâni. Ce înseamnă pentru o firmă
Din 30 septembrie, o echipă mică a publicat pe GitHub treisprezece aplicații gratuite care copiază Photoshop, Premiere, Lightroom, Word, Excel și AutoCAD, scrise în mare parte cu Claude. Cifrele luate direct din repository-uri, ce spune chiar proiectul despre stadiul lui, întrebarea juridică și ce merită să facă acum o firmă care plătește licențe.
Citește articolul