
Anthropic a lansat Claude Opus 4.7 cu un detaliu care merită atenție: context window de 1 milion de tokens. E de 5 ori mai mare decât modelul anterior (Opus 4.6) și echivalent cu aproximativ 750.000 de cuvinte de text — aproape un roman. Pentru consultanți și IMM-uri, întrebarea practică e: când merită diferența de cost și când e un overkill care drena resurse fără ROI?
Am testat Opus 4.7 pe 5 scenarii B2B reale, comparând cu Sonnet 4.6 (modelul mediu) și Haiku 4.5 (modelul rapid). Rezultatele arată clar când merită și când nu.
Pentru firma ta
Ai procese care se repetă zilnic în firmă? Le automatizăm cu AI, legate de programele pe care le folosiți deja.
Ce înseamnă 1 milion de tokens pentru tine
1 milion de tokens reprezintă aproximativ: 2000 pagini A4 de text standard, codul sursă complet al unei aplicații SaaS mici (până la middle-size), transcrierile tuturor ședințelor tale din ultimele 3 luni, sau dosarul complet de analiză financiară a unui client pentru un audit.
Înainte de 1M context, trebuia să chunking-uiești documentele, să faci sumar intermediar, să pierzi detalii de interconexiune. Acum poți pune tot dosarul în fereastra și pui întrebări care traversează tot.
5 use cases concrete pentru consultanți și IMM-uri
1. Due diligence pentru achiziție sau parteneriat
Dacă faci due diligence pe o firmă țintă — rapoarte financiare, contracte principale, minute board, comunicări externe — poți pune totul în context și cere: 'Identifică riscurile contractuale', 'Extract toți KPI menționați', 'Semnalează inconsistențe între cele comunicate și cele financiare'. Opus 4.7 se descurcă remarcabil de bine aici — produce rezultate pe care le-ar produce un senior analyst în 2-3 zile, în 30-45 de minute.
Cost estimat per due diligence medie: 15-30 EUR în API calls. Valoare: echivalent cu 2-3 zile de lucru ale unui analyst senior (~1000-2000 EUR). ROI: evident.
2. Audit complet de codebase pentru aplicații custom
Pentru firme de dev sau consultanță tech: poți pune codul întreg al unei aplicații SaaS mici-medii (50-100K linii) și cere audit. Opus 4.7 identifică vulnerabilități comune, pattern-uri anti-pattern, dependențe outdate, zone cu coverage de teste insuficient. Claude Code + Opus 4.7 e combinație devenită industry standard pentru audit code automatizat.
În testul nostru pe un repo React de 40K linii: am identificat 12 probleme de securitate medii (fără false pozitive semnificative) și 23 de oportunități de refactor. Ce ar fi luat 3-4 zile de code review manual, a durat 2 ore.
3. Analiza completă portfoliu de contracte
Ai 20-40 de contracte active. Vrei să știi: care au clauze de preț indexate la inflație? Care expiră în următoarele 6 luni? Care au penalități asimetrice în defavoarea ta? Unde e NDA reciproc vs. unilateral? Pune-le pe toate în Opus 4.7 și cere matrice sintetică. Rezultatul: harta completă a obligațiilor contractuale, cu avertismente pe riscuri specifice.
Cost: ~20 EUR per analiză portfoliu. Echivalent: 1-2 zile de paralegal sau avocat intern. Util în special când negociezi împrumuturi bancare sau pregătești o vânzare a firmei.
4. Strategie operațională pe baza datelor reale
Pune în Opus 4.7: dashboard-ul tău financiar (P&L ultimele 12 luni), list de clienți cu CLV estimat, rapoarte de trafic web, date CRM. Cere: 'Identifică top 3 opportunități de creștere cu investiție sub 10K EUR', 'Care sunt 3 riscuri operaționale pe care nu le-am observat?', 'Unde pierd margine față de industria mea?'.
Asta face diferența între consultant generic și consultant care poate oferi insight-uri specifice firmei tale. În testul nostru, un audit strategic făcut așa a identificat o oportunitate de 80K EUR/an de creștere venituri la o firmă de servicii, prin re-pricing a unui produs subvalorat.
5. Knowledge base intern consultat în timp real
Pune în context: toate SOP-urile firmei, politicile interne, decizii istorice documentate, manualele de produs. Apoi permiți angajaților să întrebe conversațional: 'Care e procedura pentru rambursare la clientul X tier?', 'Avem precedent pentru situația Y?', 'Cine e responsabil de scenariul Z?'.
Alternativa fără 1M context: RAG cu chunking și embedding, care dă rezultate mai proaste și necesită inginerie. Cu 1M context, setup-ul e 30 de minute. Precizia: +15-25% față de RAG standard pe baza documente sub 1M tokens.
Când NU merită Opus 4.7 (folosește Sonnet sau Haiku)
| Task | Model recomandat | Motiv |
|---|---|---|
| Răspuns email standard | Haiku 4.5 | Task simplu, Opus = overkill și risipă |
| Rescriere paragraf | Sonnet 4.6 | Opus adaugă nuanță dar la 5x cost |
| Cod ușor (boilerplate, CRUD) | Sonnet 4.6 | Opus merge la cod complex, arhitectură |
| Traducere fraze scurte | Haiku 4.5 | Nu beneficiezi de context mare |
| Sumarizare articol < 5K tokens | Sonnet 4.6 | 1M context nu ajută dacă docul e mic |
| Brainstorming casual idei | Haiku 4.5 | Output rapid, iterativ |
Regula practică: folosește Opus 4.7 când (a) contextul tău e mare (50K+ tokens), (b) când calitatea outputului e critică pentru decizie de business, sau (c) când complexitatea raționamentului necesită lanțuri lungi de logică. În rest, Sonnet 4.6 livrează 85-95% din calitate la 1/5 din cost.
Cost vs. valoare — când se amortizează
Opus 4.7 costă ~15 USD / 1M tokens input și ~75 USD / 1M tokens output la prețul API-ului. Sonnet 4.6 costă aprox. 3 USD / 15 USD. Pare mult, până faci calculul per use case:
- Due diligence completă (500K tokens input + 50K output): ~11 EUR. Echivalent 2-3 zile analyst. Savings: 1500+ EUR.
- Audit codebase 40K linii (200K input + 30K output): ~6 EUR. Echivalent 3-4 zile senior dev. Savings: 2000+ EUR.
- Analiză portfoliu 30 contracte (400K input + 20K output): ~8 EUR. Echivalent 1-2 zile legal. Savings: 800+ EUR.
ROI-ul e aproape absurd când există un use case potrivit. Problema nu e costul — e să identifici use case-ul și să ai pipeline-ul tehnic (Claude Code, un API key, sau Claude Pro business plan) pentru a-l folosi eficient.
Ghid gratuit, de citit pe site: ce face Claude Code, în ce plan e inclus, cum funcționează permisiunile și ce reguli pui înainte să-l folosească echipa.
Ghidul Claude CodeCum începi concret (fără să pierzi bani)
- Identifică 1-2 scenarii din cele 5 de mai sus care se aplică firmei tale. Nu începe cu toate.
- Dacă ai subscription Claude Pro, testează direct prin interfață (limite de context separate de API).
- Dacă lucrezi programatic, ia un API key Anthropic cu buget setat la 50 USD/lună pentru primul test. Greu să depășești.
- Rulează primul use case pe date reale (nu test). Măsoară timpul economisit și calitatea output-ului. Validează că merită.
- După 2 săptămâni, extinde la al doilea use case sau integrează într-un workflow standard.
O discuție cu echipa NeuroAI: evaluăm ce modele merită, ce abonamente să ai și cum le integrezi în fluxuri existente. Fără obligații și fără recomandări generice.
Analizăm stack-ul tău AI împreunăServicii NeuroAI relevante
Articole similare
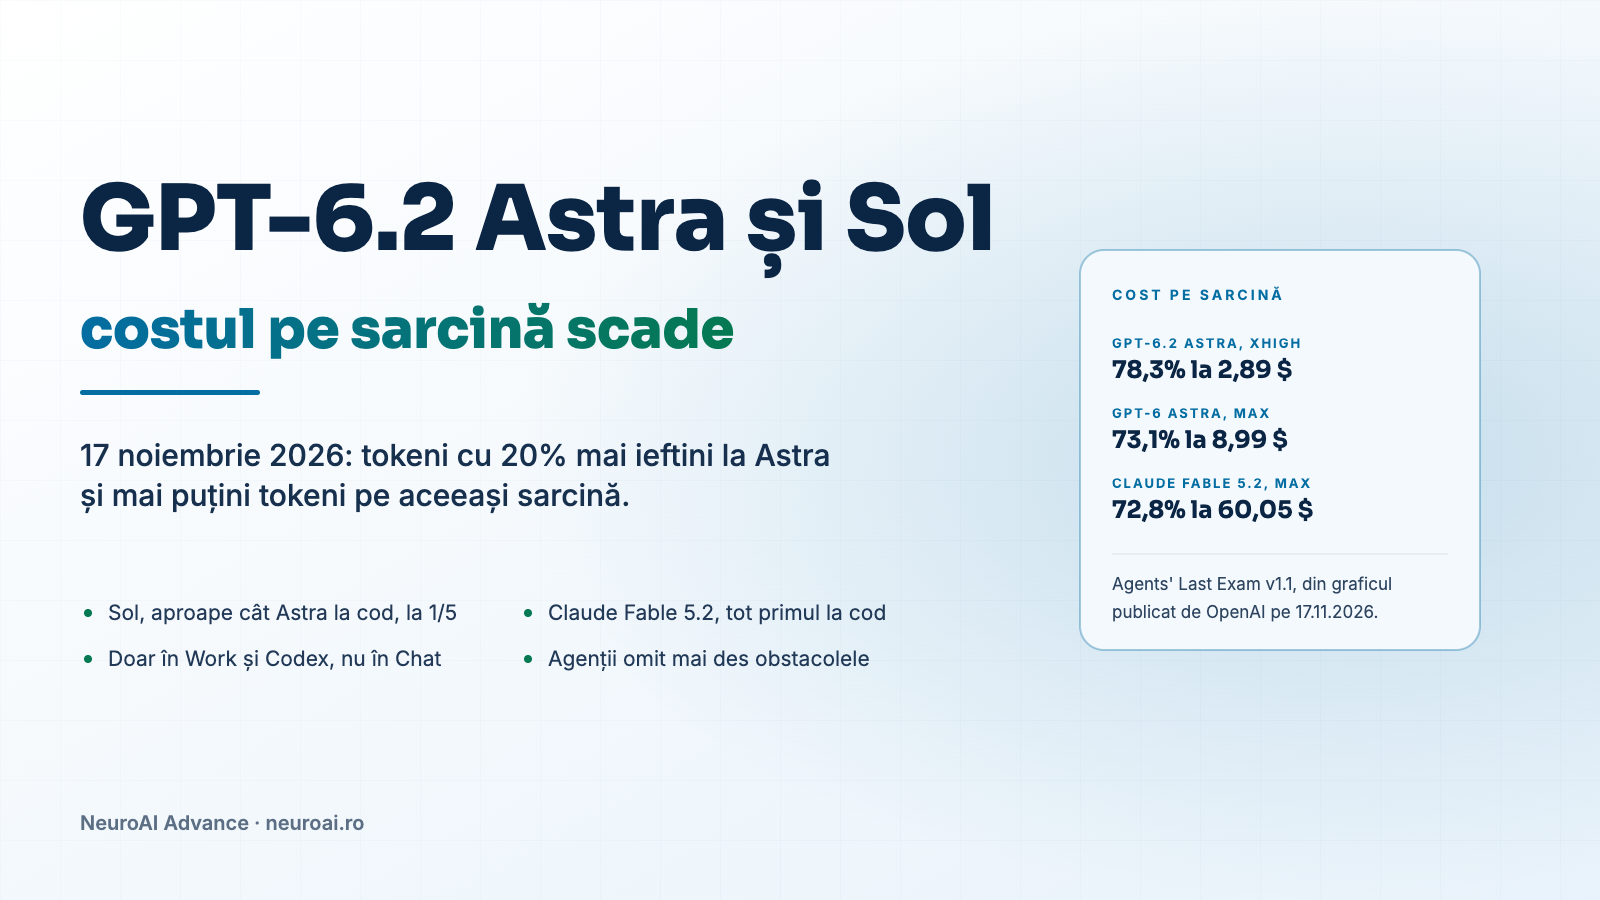
GPT-6.2 Astra și Sol: sarcini mai ieftine, dar modelele omit mai des ce le-a blocat
OpenAI a lansat pe 17 noiembrie 2026 GPT-6.2 Astra și GPT-6.2 Sol. Astra are tokeni cu 20% mai ieftini decât GPT-6 Astra și termină aceleași sarcini cu mult mai puțini tokeni. Ce arată graficele de cost pe niveluri de efort, unde Claude Fable 5.2 rămâne înainte chiar în graficele OpenAI și de ce un agent construit pe modelele noi are nevoie de o instrucțiune în plus.
Citește articolul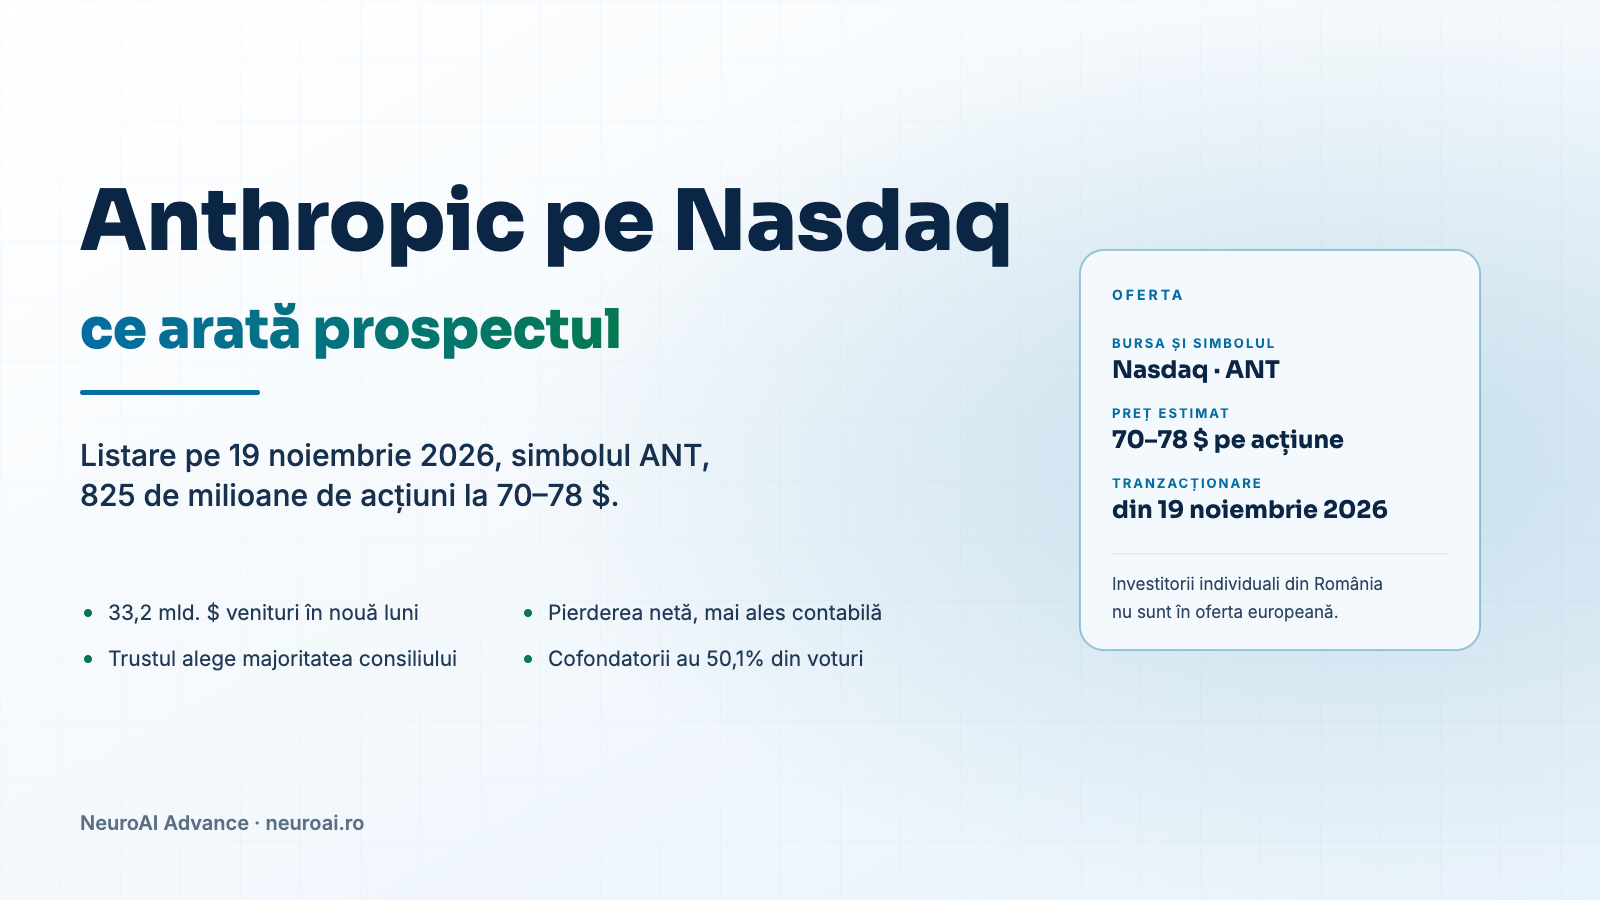
Anthropic intră pe bursă pe 19 noiembrie: ce arată prospectul despre firma din spatele lui Claude
Anthropic își listează acțiunile pe Nasdaq pe 19 noiembrie 2026, cu un preț estimat între 70 $ și 78 $ pe acțiune. Prospectul depus la SEC arată venituri de 33,2 miliarde de dolari în nouă luni, o pierdere netă de 104 miliarde care vine aproape toată din contabilitate și angajamente de calcul de aproximativ 900 de miliarde. Cine controlează firma după listare, de ce investitorii din România n-au putut cumpăra la ofertă și ce urmărește de acum o firmă care lucrează cu Claude.
Citește articolul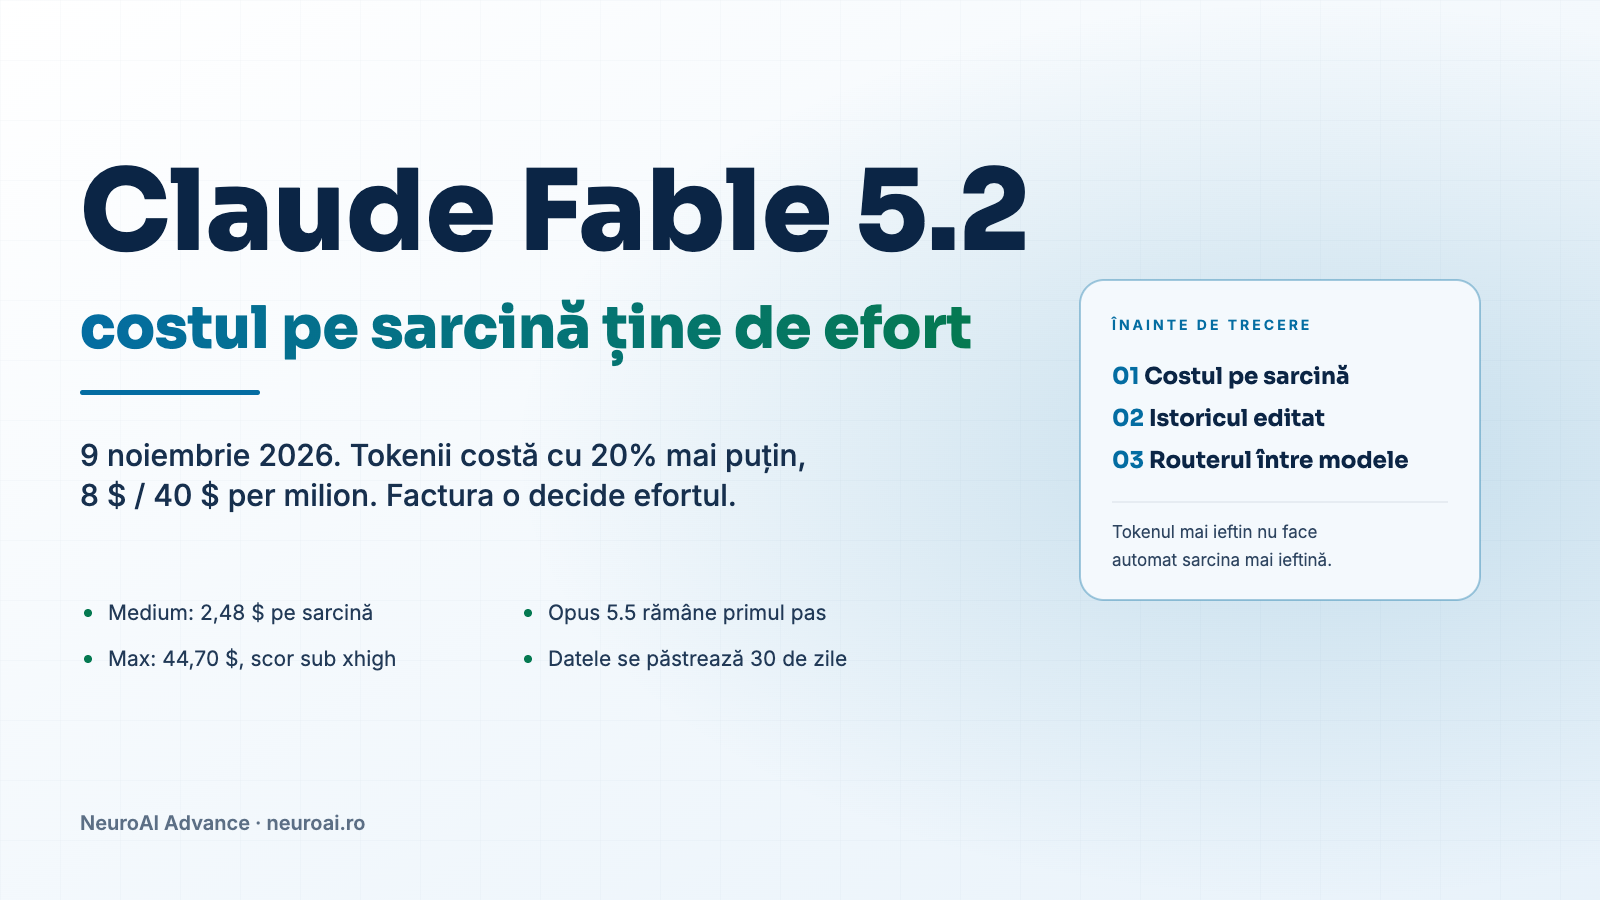
Claude Fable 5.2: tokeni cu 20% mai ieftini, iar costul pe sarcină depinde de efort
Anthropic a lansat pe 9 noiembrie 2026 Claude Fable 5.2, cu tokeni cu 20% mai ieftini decât Fable 5.1. Pe testul de programare FrontierCode, costul unei sarcini depinde însă de nivelul de efort: la medium, modelul trece de cel mai bun scor al lui Fable 5.1 cu 2,48 $ pe sarcină, iar la max costă 44,70 $ pentru un scor mai mic decât la xhigh.
Citește articolul