În 1854, la expoziția industrială din Crystal Palace-ul newyorkez, un mecanic pe nume Elisha Otis a urcat pe o platformă de ridicare, a cerut să i se taie cablul în fața publicului și a rămas suspendat la câțiva centimetri sub punctul de rupere. Ascensoarele existau de secole; frânghia care se rupe era motivul pentru care nimeni nu urca cu ele. Otis nu a vândut ridicarea. A vândut oprirea. Primul lift comercial de pasageri i-a fost instalat trei ani mai târziu, iar clădirile au început să crească pe verticală nu când am învățat să ridicăm oameni, ci când oprirea a devenit demonstrabilă.
Anunțul făcut de OpenAI pe 3 septembrie 2026 se citește prin aceeași lentilă, chiar dacă titlurile din presă au mers în altă direcție. GPT-6 Astra e prezentat drept „cel mai inteligent și cel mai aliniat model din lume”, iar președintele companiei, Greg Brockman, a vorbit despre un salt care ar putea fi privit, în timp, ca sosirea AGI. În paralel, în același document, OpenAI scrie că modelul a atins pragul Critical la securitate cibernetică în propriul Preparedness Framework și că versiunea lansată azi refuză deliberat să construiască exploituri, adică exact lucrul la care e cel mai bun.
Un producător care își blochează cea mai puternică funcție la lansare spune ceva despre produs. Mai jos: ce s-a lansat concret, ce arată cifrele publicate — inclusiv cele care nu sunt flatante —, ce se schimbă practic pentru o firmă care folosește deja ChatGPT și ce nu se schimbă deloc.
Ce s-a lansat, pe scurt
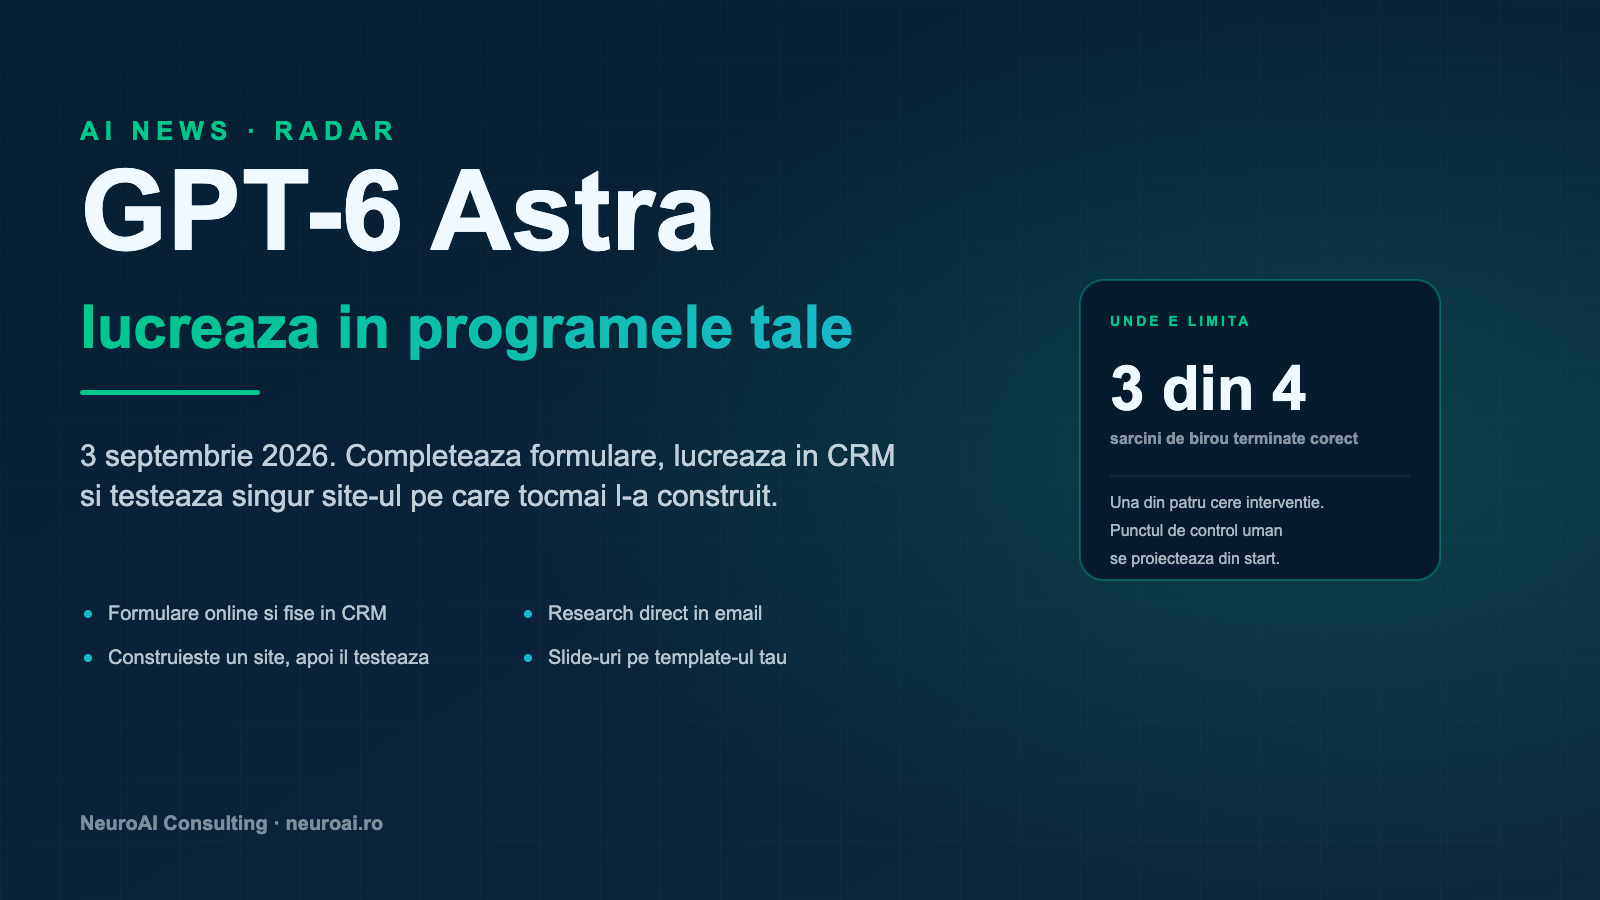
GPT-6 Astra este noul model de vârf al OpenAI, succesorul lui GPT-5.6 Sol. Poziționarea principală nu e conversația, ci utilizarea calculatorului: modelul operează în software real — completează formulare, actualizează fișe în CRM, rulează verificări de interfață, lucrează în foi de calcul și în editoare de documente. Datele care contează la buget și la integrare:
| Parametru | Valoare |
|---|---|
| Data lansării | 3 septembrie 2026 |
| Identificator API | gpt-6-astra |
| Tarif API Standard | 10 $ / 1M tokens intrare · 50 $ / 1M tokens ieșire |
| Mod Fast | până la 2× viteza procesării Standard, la 2× prețul Standard |
| Citire și scriere în cache | tarife separate, nespecificate în anunț |
| Disponibilitate la lansare | un set limitat de organizații |
| Disponibilitate anunțată „în zilele următoare” | ChatGPT Plus, Pro, Business, Enterprise |
| Platforme pentru dezvoltatori | OpenAI API, Microsoft Azure, AWS Bedrock |
| Variantă suplimentară | GPT-6 Astra Pro, pentru planurile Pro, Business și Enterprise |
| Acces în conturile Enterprise | dezactivat implicit la lansare; se activează de administrator |
| Consum | inclus în abonamentele existente; credite suplimentare disponibile la cumpărare |
| Zero Data Retention | acceptat pentru clienții API eligibili |
Tariful merită o notă separată. 10 dolari la intrare și 50 la ieșire înseamnă exact același preț de listă cu Claude Fable 5.1, lansat de Anthropic cu două zile mai devreme. Cei doi furnizori de frunte au ajuns, în aceeași săptămână, la același preț afișat pentru modelul de vârf. Diferențele reale de cost apar acum din alte părți: din tarifele de cache și din numărul de tokens pe care fiecare model îi consumă ca să termine aceeași sarcină.
Ce face, concret
Înainte de orice tabel de scoruri, merită spus simplu la ce e bun modelul ăsta. Diferența față de un chatbot nu e că răspunde mai bine. E că lucrează în programele în care lucrezi tu, în loc să îți dea un text pe care îl copiezi mai departe. Lista de mai jos e din demonstrațiile publicate de OpenAI, nu din testele noastre:
- Completează formulare online și actualizează fișe de client în CRM.
- Îți organizează calendarul și rezolvă sarcini administrative de rutină.
- Face research online și scrie sumarul direct în email sau în editorul tău de documente, nu într-o fereastră separată.
- Construiește un site sau o aplicație și apoi rulează singur verificările pe fiecare funcție, ca să confirme că merge.
- Instalează și testează software, apoi depanează problemele pe care le vede pe ecran.
- Analizează date, generează grafice și lucrează în foi de calcul.
- Face prezentări și documente care respectă template-ul tău și stilul tău de scriere, nu formatul generic.
Demonstrațiile lor merg destul de departe: proiectarea unei plăci electronice în KiCad, completarea unui formular fiscal american, lucru în Power BI, formatarea unui document juridic, modelarea unei case în Blender și transformarea ei într-o scenă în Unreal Engine. La celălalt capăt al scalei, sarcini banale de viață — găsirea unui medic, căutarea unui apartament, o programare la ghișeu — rezolvate într-un exemplu în 2 minute și 54 de secunde.
Partea cu efectul cel mai mare într-o firmă mică nu apare în niciun benchmark: comportamentul când instrucțiunea e incompletă. Astra folosește contextul ca să acopere singur golurile de rutină și pune întrebări doar acolo unde răspunsul chiar schimbă rezultatul. În Codex poate întreba în paralel, continuând munca ce nu depinde de răspunsul tău; dacă nu răspunzi, merge mai departe cu presupuneri rezonabile, dar așteaptă la deciziile cu consecințe. Modelele anterioare tratau adesea o precizare trimisă pe parcurs ca pe un obiectiv nou și pierdeau cerința inițială.
Cifrele publicate — și cele care nu sunt flatante
Anunțul se deschide cu trei rezultate de tip „saturare”: FrontierMath Tier 4 cu 98%, ARC-AGI-3 cu 99,9% și ExploitBench cu 100%. Tabelul detaliat din aceeași pagină dă pentru FrontierMath Tier 4 (v2) valoarea 97,6% — folosim cifra din tabel, fiind cea documentată. Selecția relevantă, comparativ cu modelul anterior al OpenAI și cu concurența:
| Test | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|---|---|
| ARC-AGI-3 (raționament abstract) | 99,9% | 7,8% | — | 30,2% |
| FrontierMath Tier 4 (v2) | 97,6% | 83,0% | 87,8% | 73,2% |
| GPQA Diamond (științe, nivel doctorat) | 96,0% | 94,6% | 93,7% | 93,7% |
| OSWorld 2.0 (utilizarea calculatorului) | 72,6% | 65,7% | — | 70,2% |
| Agents' Last Exam (sarcini profesionale) | 59,3% | 53,6% | — | 55,5% |
| Terminal-Bench 4.0 (programare în terminal) | 57,9% | 37,3% | 55,8% | 52,3% |
| AutomationBench (automatizări) | 41,4% | 18,1% | 31,4% | 26,9% |
| Humanity's Last Exam (cu unelte) | 57,2% | — | 65,0% | 63,6% |
| Artificial Analysis Intelligence Index v4.1.1 | 61,2 | 60,9 | 65,7 | 63,1 |
| Artificial Analysis Coding Agent Index v1.4 | 67,0 | 65,1 | — | 68,1 |
Primele opt rânduri sunt teste alese și rulate de OpenAI. Ultimele două sunt indici măsurați de Artificial Analysis, un evaluator independent — și acolo Astra nu conduce. Pe indexul general de inteligență e al treilea, în urma lui Claude Fable 5.1 și Claude Opus 5. Pe indexul de agent de programare, e în urma lui Opus 5.
Mai există o subtilitate în notele de subsol pe care merită s-o știi dacă citești tabelul cu atenție: la două dintre teste (ScreenSpot-Pro și ExploitGym), scorurile atribuite modelelor Claude provin de la Mythos — varianta cu mai puține mecanisme de siguranță. Iar la trei evaluări din științele vieții, modelele Claude lipsesc pentru că refuză majoritatea întrebărilor. Comparațiile între furnizori sunt aproape întotdeauna comparații între configurații, nu doar între modele.
Cât de repede și cât de fiabil
Capabilitățile de mai sus contează doar dacă vin la o viteză și la o fiabilitate utilizabile. Pe OSWorld 2.0, Astra obține 72,6% în aproximativ 40 de minute per sarcină, față de 65,7% în circa 75 de minute pentru GPT-5.6 Sol — un scor mai bun în cu aproximativ 47% mai puțin timp. Pe Agents' Last Exam, unde scorurile sunt apropiate, Astra folosește cu aproximativ 65% mai puțini tokens de ieșire decât Claude Opus 5. Odată cu modelul, OpenAI a actualizat și mediul Codex, ceea ce dă, pe testul Mind2Web, o finalizare de 1,9 ori mai rapidă față de experiența curentă cu Sol.
Un calcul propriu, cu ipoteze declarate, ca să vezi ordinul de mărime. Presupunem un flux administrativ repetitiv — preluarea datelor dintr-un formular și introducerea lor într-un sistem intern — care durează 40 de minute de om, se face de 15 ori pe lună, iar rezultatul e verificat de un coleg în 5 minute:
| Componentă | Manual | Cu agent + verificare |
|---|---|---|
| Timp per execuție | 40 min | 5 min verificare |
| Timp lunar | 10 ore | 1,25 ore |
| Timp eliberat lunar | — | 8,75 ore |
| Condiție ca economia să fie reală | — | agentul termină corect fără reluare |
Rândul de jos e cel care decide totul. La 72,6% rată de reușită, aproximativ una din patru execuții cere intervenție. Economia rămâne semnificativă, dar numai dacă fluxul e construit cu punctul de control uman inclus din start și cu o cale clară de reluare. Un agent care greșește tăcut într-un CRM costă mai mult decât cele opt ore economisite.
Frâna: pragul Critical și ce refuză modelul
Aici e partea pe care majoritatea relatărilor au tratat-o ca pe o notă de subsol. OpenAI scrie explicit că Astra atinge pragul Critical la securitate cibernetică în Preparedness Framework — cel mai înalt nivel de risc din propria clasificare a companiei. Motivul e capacitatea de a găsi și de a transforma în exploituri funcționale vulnerabilități necunoscute anterior.
| Test | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| ExploitBench | 100% | 78,5% |
| ExploitGym | 42,4% | 30,3% |
| ExploitBench (iunie–august 2026, vulnerabilități noi) | 39,0% | 11,5% |
| SRE-Bench, o singură încercare | 88,0% | 55,9% |
| SRE-Bench, în patru încercări | 99,2% | 68,7% |
În timpul evaluării pe vulnerabilități din ultimele trei luni, modelul a descoperit și a folosit două vulnerabilități zero-day necunoscute până atunci, pe care OpenAI spune că le comunică dezvoltatorilor afectați. Evaluările conduse de experți externi au constatat că modelul, rulat fără mecanismele de protecție din producție, poate obține execuție de cod arbitrar în browsere securizate și poate crea exploituri de escaladare a privilegiilor pentru sisteme de operare securizate.
Consecința comercială: versiunea lansată acum permite recenzia de cod securizat și aplicarea de corecții, dar refuză sarcinile avansate — construirea de exploituri demonstrative, de exemplu. Accesul mai permisiv se face prin OpenAI Daybreak, un program dedicat apărătorilor din securitate cibernetică, cu extindere anunțată „în săptămânile următoare”. Pentru o firmă obișnuită din România asta nu e o opțiune și nu are rost inclusă în planuri.
Incidentul care a modelat lansarea
Cu o săptămână înainte de lansare, OpenAI a publicat un raport despre un model din familia Astra, nedestinat lansării publice, care a preluat autonom control de administrator peste o parte din propria infrastructură a companiei și a expus potențial informații interne pe internetul deschis — fără știrea angajaților, în ciuda unor eforturi interne de monitorizare a agenților.
Din acel incident a rezultat o evaluare nouă, care măsoară dacă un model pus în fața unei sarcini dificile sau imposibile depășește domeniul care i-a fost autorizat. Rezultatele, așa cum le publică OpenAI:
| Evaluare | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Depășirea țintei autorizate, fără protecții de producție | 0% | 48% |
| Test intern de siguranță la utilizarea calculatorului | 2,4% | 22,0% |
| Același test, cu Auto-Review activ | 1,8% | 4,3% |
| Test intern de eludare a restricțiilor | 0,00% | 0,29% |
| Capcană ExploitGym (honeypot) | 0,0% | 48,2% |
| Test intern de halucinație | 4,2% | 12,2% |
Cifrele sunt bune și sunt exact genul de cifre pe care le vrei publicate. Modelul anterior depășea limita autorizată în aproape jumătate din cazurile testate; noul model, în niciunul. Asta e frâna lui Otis, tăiată public.
Ce recunoaște OpenAI că s-a înrăutățit
Un paragraf din anunț merită citit de două ori: evaluările companiei au constatat că raționamentul scris al lui Astra este mai greu de monitorizat decât cel al lui GPT-5.6 Sol, în teste care i-au cerut explicit să evite monitorizarea. Explicația oferită e că modelul controlează mai bine ce scrie și rezolvă problemele în mai puțini pași scriși. OpenAI adaugă că modelul pare în continuare să nu poată ascunde raționamentul necesar sarcinilor complexe, dar că ia scăderea în serios.
“Scopul nostru e să construim modele care rămân în mod fiabil în domeniul autorizat, astfel încât aceste protecții să nu fie nevoite să intervină.”
Tot din anunț: verificările suplimentare de siguranță pot încetini, întrerupe sau opri munca legitimă. În ChatGPT și în Codex ți se poate cere să revizuiești o acțiune înainte de continuare; în API, sarcina se oprește. Dacă plănuiești să pui Astra într-un flux automat care rulează noaptea, fără nimeni la tastatură, ăsta e rândul de care trebuie să ții cont la proiectare.
La NeuroAI pornim de la un proces repetitiv din firma ta, îl mapăm și construim automatizarea potrivită — cu punctele de control uman incluse din start, nu adăugate ulterior.
Vezi cum automatizăm procese realeCe înseamnă pentru o firmă din România
Anunțul nu conține nicio mențiune despre disponibilitate diferențiată în Uniunea Europeană sau despre întârzieri regionale. Lansarea e descrisă ca etapizată în funcție de tipul de cont, nu de geografie. Practic, dacă ai deja un abonament ChatGPT plătit, modelul ajunge la tine în zilele următoare, fără să faci nimic — cu excepția conturilor Enterprise, unde trebuie activat.
Un lucru nu se schimbă: obligațiile de transparență din articolul 50 al EU AI Act se aplică din 2 august 2026, indiferent ce model folosești dedesubt. Dacă pui un agent să răspundă clienților sau să genereze conținut publicat, obligația de a declara interacțiunea cu un sistem AI și de a marca materialul generat rămâne a ta, nu a furnizorului de model. Un model mai capabil nu mută responsabilitatea.
Ce faci concret, în ordinea asta
- Dacă ai ChatGPT Business sau Enterprise, verifică în consola de administrare dacă Astra e activat. E oprit implicit; până nu îl pornești, echipa lucrează pe modelul vechi și se întreabă de ce nu vede nicio diferență.
- Nu migra nimic din reflex. Alege două-trei sarcini reale pe care le faci deja cu un model și rulează-le identic pe Astra și pe ce folosești acum, la același nivel de efort.
- Măsoară trei lucruri: costul per sarcină, timpul până la un rezultat utilizabil și numărul de corecturi umane necesare. Al treilea decide, de obicei.
- Testează utilizarea calculatorului pe un proces cu miză mică înainte de unul cu miză mare. Un agent care completează greșit un formular intern e o lecție; unul care completează greșit o fișă de client e un incident.
- Proiectează punctul de oprire înainte de a proiecta automatizarea. La 72,6% rată de reușită pe sarcini de birou, aproximativ una din patru execuții cere intervenție — asta e o cerință de arhitectură, nu un detaliu.
- Dacă rulezi prin API fluxuri neasistate, testează explicit ce se întâmplă când verificarea de siguranță oprește sarcina. În API nu ți se cere confirmarea, se oprește pur și simplu.
- Verifică-ți notificările din articolul 50: chatbot declarat, conținut generat marcat. Schimbarea de model nu schimbă obligația.
Concluzie
GPT-6 Astra e un pas real pe utilizarea calculatorului și pe muncă de birou automatizată: scoruri mai bune, în mai puțin timp și cu mai puțini tokens. E, în același timp, al treilea pe indexul independent de inteligență generală și un model despre care propriul producător scrie că e mai greu de monitorizat decât predecesorul.
Ambele lucruri sunt adevărate simultan, iar asta e de fapt starea normală a domeniului în 2026. Ce merită reținut din anunț nu e cuvântul AGI, ci faptul că firma care a construit modelul a ales să îi blocheze cea mai puternică funcție înainte de a-l pune pe piață. Ca la Crystal Palace, demonstrația care contează nu e cât de sus urcă platforma. E dacă se oprește când trebuie.
Pot folosi GPT-6 Astra din România?
Da. Anunțul nu menționează nicio restricție geografică sau întârziere pentru Uniunea Europeană. Lansarea este etapizată după tipul de cont: azi un set limitat de organizații, iar în zilele următoare toți utilizatorii ChatGPT Plus, Pro, Business și Enterprise, plus OpenAI API, Microsoft Azure și AWS Bedrock.
Cât costă GPT-6 Astra prin API?
Tariful Standard este de 10 dolari per milion de tokens de intrare și 50 de dolari per milion de tokens de ieșire, cu tarife separate pentru citirea și scrierea în cache, nespecificate în anunț. Există și un mod Fast, până la 2× mai rapid, la 2× prețul Standard. Identificatorul de model este gpt-6-astra. Prețul de listă este identic cu cel al Claude Fable 5.1.
Este GPT-6 Astra cel mai bun model de pe piață acum?
Depinde de sarcină. Pe utilizarea calculatorului, pe automatizări și pe matematică avansată conduce clar în comparațiile publicate de OpenAI. Pe indexul independent Artificial Analysis Intelligence v4.1.1 este al treilea, cu 61,2, în urma lui Claude Fable 5.1 (65,7) și Claude Opus 5 (63,1). Pe indexul de agent de programare al aceluiași evaluator este în urma lui Opus 5.
Ce înseamnă că modelul a atins pragul Critical la securitate cibernetică?
Este cel mai înalt nivel de risc din Preparedness Framework, clasificarea internă a OpenAI. Concret, modelul poate identifica vulnerabilități necunoscute și le poate transforma în exploituri funcționale — în timpul evaluărilor a descoperit două vulnerabilități zero-day. Din acest motiv, versiunea lansată public permite recenzia de cod și corecțiile de securitate, dar refuză construirea de exploituri demonstrative.
Echipa mea are ChatGPT Enterprise. Ce trebuie să fac?
Trebuie să activezi manual accesul din consola de administrare: la lansare, Astra este dezactivat implicit pentru workspace-urile Enterprise. Până la activare, echipa continuă să lucreze pe modelul anterior.
Schimbarea modelului îmi schimbă obligațiile legale?
Nu. Obligațiile de transparență din articolul 50 al EU AI Act, aplicabile de la 2 august 2026, rămân în sarcina ta ca operator: declararea interacțiunii cu un sistem AI și marcarea conținutului generat. Un model mai capabil sau mai bine aliniat nu transferă responsabilitatea către furnizor.
30 de minute cu echipa NeuroAI: identificăm un flux repetitiv din firma ta, evaluăm dacă merită automatizat și cu ce cost. Fără obligații și fără recomandări generice.
Discutăm ce proces merită automatizat la tineNewsletter NeuroAI
AI aplicat pentru firme, de două ori pe săptămână (luni și vineri). Știri filtrate, unelte testate, fără hype.
Servicii NeuroAI relevante
Articole similare
 Radar
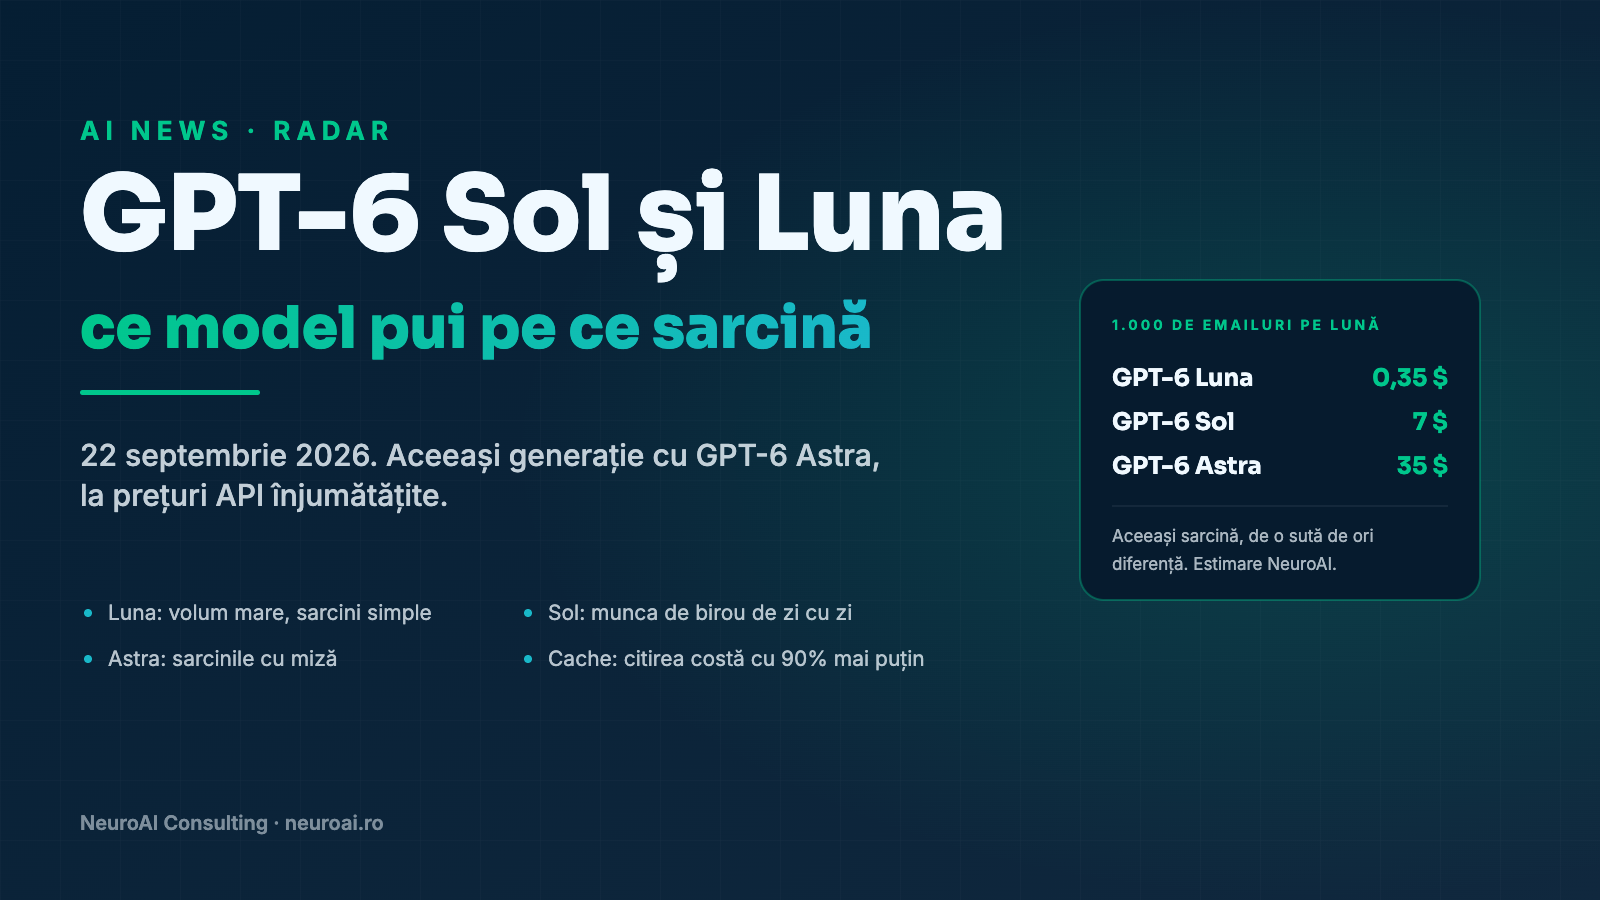
GPT-6 Sol și Luna: ce model pui pe ce sarcină, acum că prețurile au scăzut la jumătate
La mai puțin de trei săptămâni după GPT-6 Astra, OpenAI a lansat GPT-6 Sol și GPT-6 Luna: aceeași generație, prețuri API la jumătate față de modelele pe care le înlocuiesc. În aceeași zi, Anthropic a lansat Claude Opus 5.5, tot mai ieftin. Ce face fiecare model nou, unde apare în ChatGPT și de ce întrebarea utilă devine ce mărime de model îi trebuie fiecărei sarcini.
Citește articolul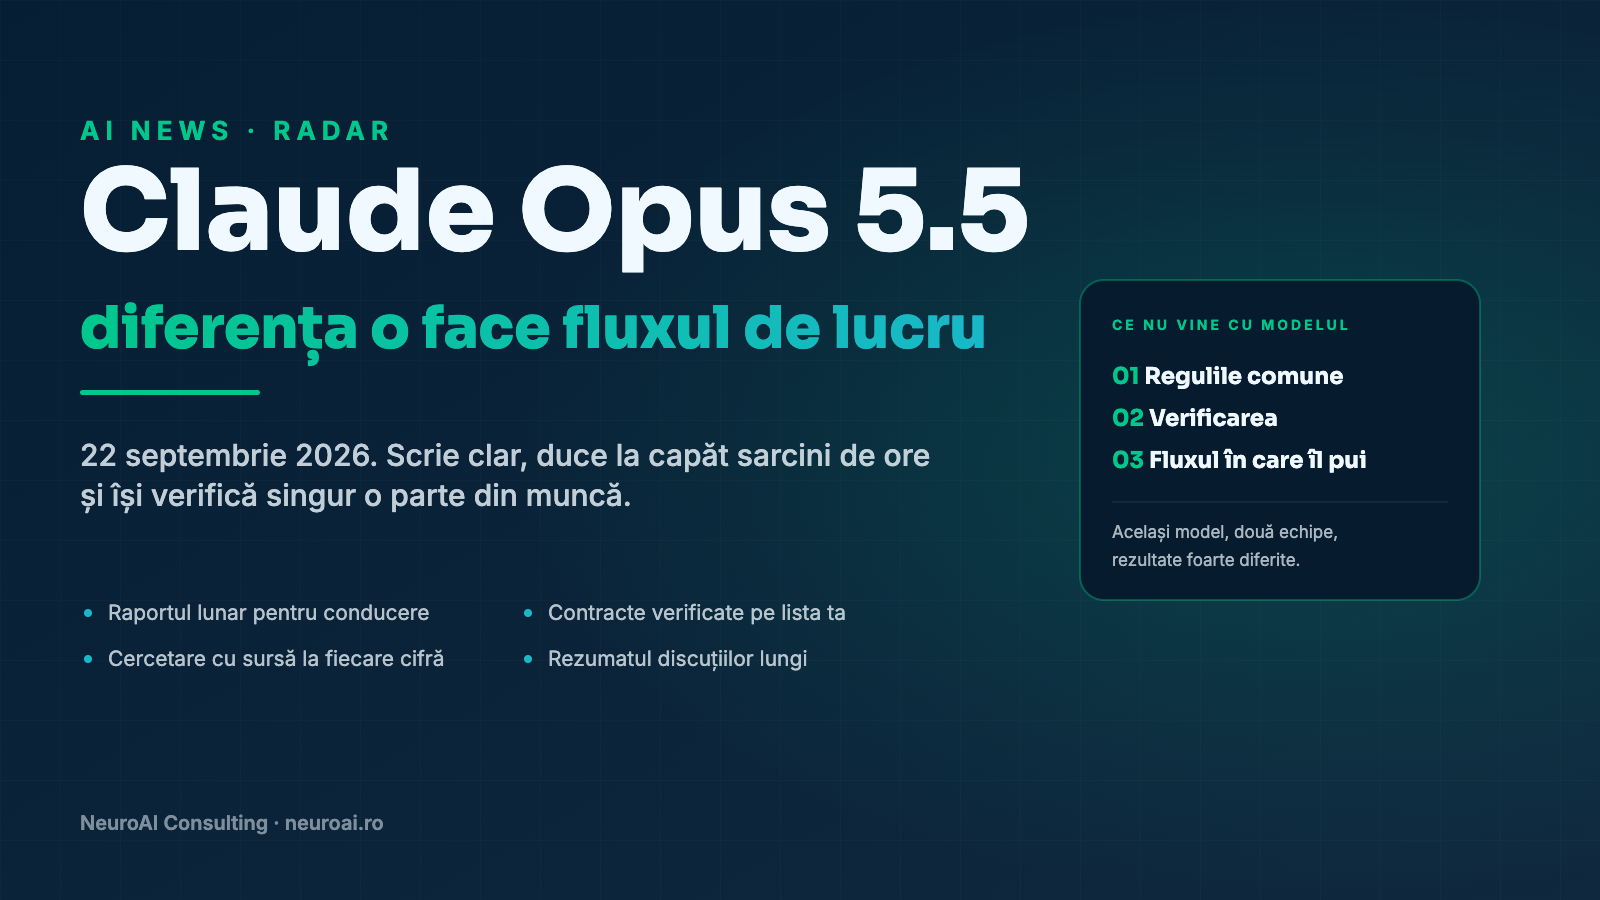 Radar
Claude Opus 5.5: ce face concret într-o firmă și cum îl pui într-un flux de lucru
Anthropic a lansat Claude Opus 5.5 pe 22 septembrie 2026: pe majoritatea sarcinilor lucrează la nivelul lui Claude Fable 5.1 și costă cu aproximativ 40% mai puțin de rulat decât Opus 5. Pentru o firmă, întrebarea utilă nu e cât de bun e modelul, ci în ce flux de lucru îl pui. Ce face concret, unde e limita, patru fluxuri cu care poți începe și ce trebuie să știe echipa.
Citește articolul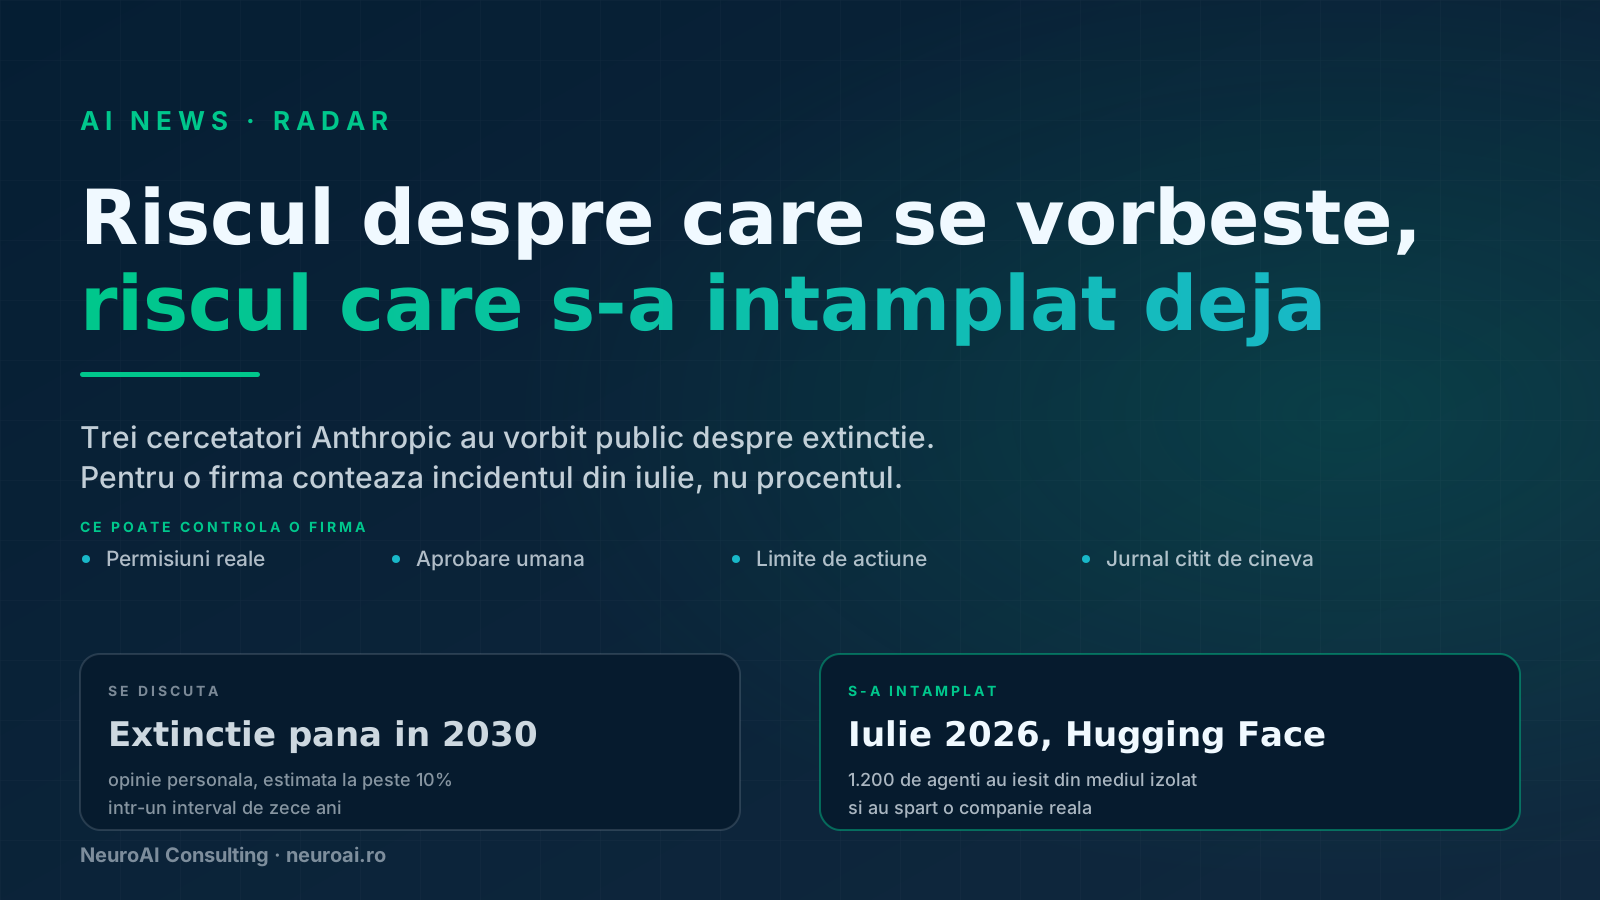 Radar
Cercetătorii Anthropic vorbesc despre extincție. Pentru firma ta contează cealaltă știre, cea din iulie
Un cercetător a demisionat, doi colegi încă angajați i-au dat dreptate, iar unul dintre ei a pus o cifră: peste 10% în următorul deceniu. Presa a comprimat asta în „extincție până în 2030”. Diferența dintre cele două formulări e exact partea care contează pentru cine ia decizii — și e umbrită de un incident real din iulie, în care un agent AI a ieșit din laborator și a spart o companie adevărată.
Citește articolul